deepinfer talk
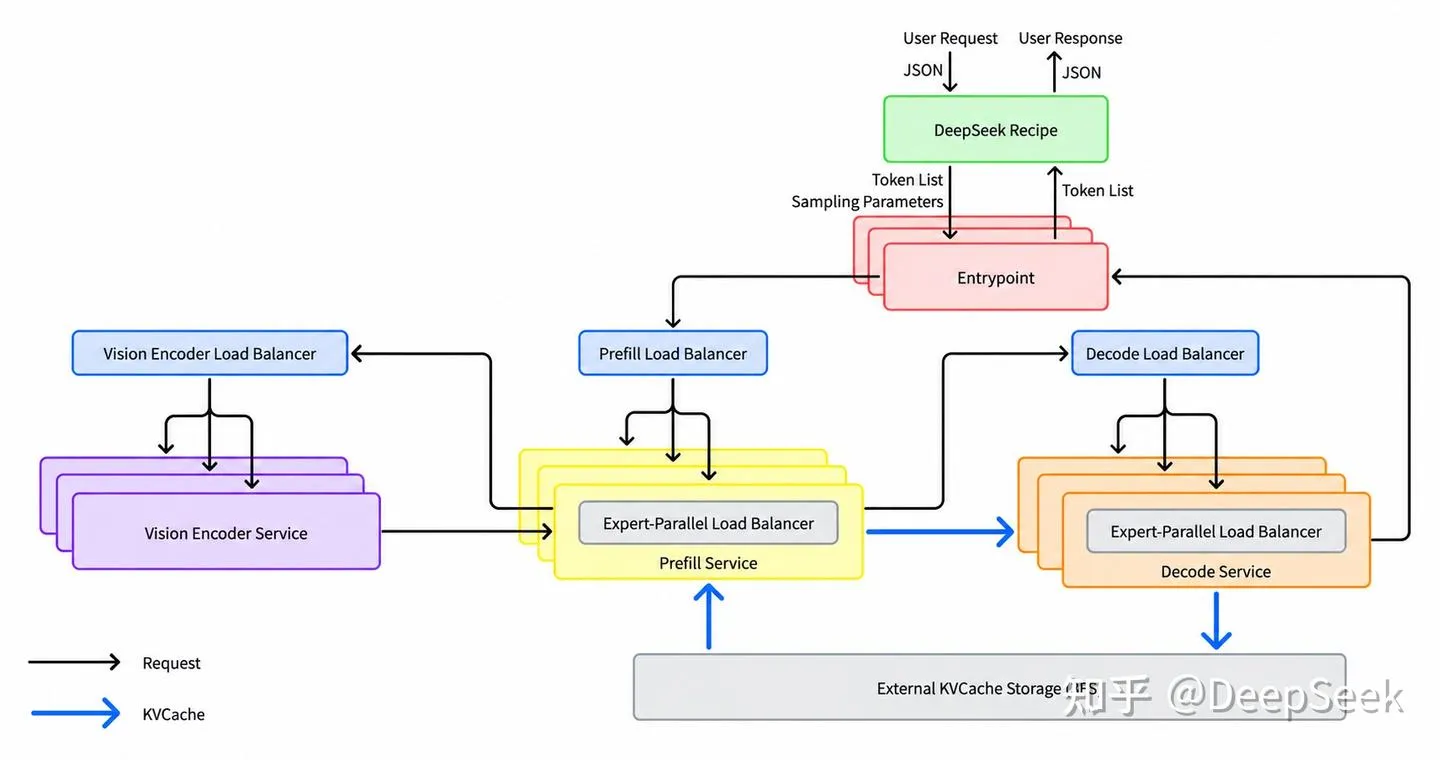
整体架构:EPD 分离
首先呢是 epd 分离,也就是 encoder,prefill,decode,其中 prefill 和 decode都有一个池化的存储,系统里还有单独的专用存储节点。
- prefill采用尽可能小的并行组(EP only):因为 prefill 是 compute bound,只要能充分利用好硬件自身的计算资源,EP4 -> EP8 不改善总体吞吐。
- decode 追求wideep:因为大概率 decode 是 memory bound,EP 可以通过通信换带宽改善整体效率,包括留下更多 GPU 空间撑起更大的 batch size,冗余更多专家等。他自己也给了一个图。
- Encoder: 单卡,便宜 GPU 即可
暂时不使用 TP 与 CP, 不用 TP 的点在于说,TP通过交换一些峰值吞吐改善延迟。在延迟不是一个巨大的问题的时候,尽可能不开 TP。
但这里它没有聊Prefill PP,因为理论上 Prefill PP 也不改变峰值吞吐(有一点轻微的流水线问题),不过 v4.1 跨层共用 kv cache 的结构其实对 pp 不太友好。
当然我有一个想法是,prefill 到底是 pp 还是 ep,当然现在模型训成 每一个 Layer 都不一样的,那天生也就对 pp 不友好,那也没招。但是 ep 要完整做完 ds 这一套,需要不少流量和 prefill worker。
我的想法在于,虽然 EP 吞吐高,但是如果有超长 prefill 怎么办,比如要 prefill 一个 500k 的请求,不过v4.1 flash 本身 prefill flops 就少很多,算也不会太慢。但是对于其他模型,比如 k3 glm 来说,flops 还是不低的。
另一个方面是,v4.1 flash 架构上对pp 不友好,因为有包括跨层的 kv cache 复用。
总的来说在中小部署我看好 pp(几个 prefill worker 这种),大部署我才看好 ep。
存储:池化兜底,不做 cache aware
为什么池化
在之前开源世界里,首先大家一开始并没有一个合适的池化的存储,大部分开源的kv cache 组件都是本地的,他们并不互通,即使“声称”互通,如果实际走的是 tcp,或者低效 RDMA,也实际上算不互通,进一步导致 router 必须做 cache aware。即使现在,我感觉开源的 KV Cache 方案也还有很多路要走。
cache aware 与否,让我想起来数据库领域的 share nothing(类比 cache aware,强调本地性) 与 share storage(类比池化) 之争: 历史脉络,80-00 年代,share nothing赢,当时硬件的能力,做池化很吃亏,包括一些协议没有优化好。在硬件和系统研究逐渐完善后,2015 年后,PolarDB, Redshitf 等都走上了这条路,截止现在,连一些当年坚定 share nothing 的数据库,也开始支持存算分离。
share nothing 赢,赢在网络和协议无法做好池化。现在 RDMA 标配可能都是 8 个计算 nic + 一个存储或者说管理 nic,两者都是很快,网络带宽和延迟都不再是稀缺资源,稀缺的反而变成了计算资源(GPU 的成本是最高的)的弹性,利用率,运维方便。
在 25 年年底,我写了一些关于 cache aware 的博客
https://zhuanlan.zhihu.com/p/1955282595844687283
当然我觉得存算分离还有组织架构上的好处,而非单纯技术,性能上的,因为如果不分离,意味着上层要感知过多的存储逻辑,它是怎么工作的,怎么做好局部性。而分离后,上下两层,各自根据接口进行工作的开展,上层可以完全专注在 load balance 定义上,下层则可能是在这个接口和 workload 下,解决好流量,放置等问题。
cache aware 与否,更多也取决于,能拿到什么集群,有什么研发 team。即使有钱买到 600TB 的存储节点,部署,维护,一个类似3FS 的东西,绝非只靠 CC 就能解决的,还是需要一些存储研发的。
cache aware 解决的是局部性和负载的跷跷板,而且是在线的,整体难度很大。
池化只需要关注局部性,把复杂度下放到的存储,网络,拥塞,incast,失败等。
存储硬件与 3FS
它文章里说的存储服务器很豪华啊,20 个 30.78TB 的 SSD,也就是单台接近,600TB,但它后文又说了,每台提供 40GB/s 的都和 5GB/s 的写。如果按 PICE 4.0 时代估算的话,Samsung PM1733a 可能是一个接近的规格(不过停产了), 20 个SSD 组起来,读带宽按照理论规格打满有 150GB/s,写带宽有 82GB/s,但这个是理论推算,实际可能要 EC,多副本等。对于用做 kv cache 的 SSD 来说,寿命反而是一大问题,因为 SSD 基本一直要承接较高的写流量(你不能选择某个用户的 kv cache 存,某个的不存),只能都存,所以需要根据 SSD 规格实际推算他的寿命。
GPU : SSD 的“逻辑大小”是 14.4TB,后面说了,数据以 10+2 EC 存储在 3FS 上(简单说就是膨胀 20%),14.4 TB 膨胀后到 17. 28 TB. 读会直接给 11 个节点发请求,这里有一个有意思的论文是Jeff Dean 那篇《The Tail at Scale》,11 节点应该还能改善一些长尾,感兴趣的可以自行读一下,还有一篇是EC-Cache(OSID 16),这个是存储相关,不细致展开了。
存到 3fs 应该是单副本(代码本身也支持 chain 长度为 1,因为 3fs 是 chain replication),3fs 理论上不感知“EC”本身,更多是管理 EC 的placement 问题,你比如 12 个 ec shard,应该放到 12 个机器上,每个机器承担的 ec shard 应该均衡等。还有一个要考虑的点是,挂了单个机器之后的重建流量的平衡。这个问题叫做,平衡不完全区组设计,早在 1930 年就出来了,是关于怎么在众多土地上测试十多种新化肥的。也有点类似数独。
但这个 EC 相关的计算逻辑没有开源出来,一些相关脚本倒是看到了。应该也是做到 3FS 里的,不过 3FS 开源过一次后,后面不咋更新了。
kv cache
首先我们要知道 v4.1 有两种 cache,一个是 CSA 的 kv cache,topk + 压缩,page size 是 128(压缩前),叫 block kv cache,和普通 paged attention 一样,每个请求一张 block table 去索引。
然后是 SWA,就是滑动窗口注意力,窗口 128,每个请求固定大小,占一个槽位(StateBlock),槽内按 pos % 134 当环形 buffer 用,多出来的 6 个是给 MTP 投机失败回退留的。
SWA 的分配是静态的,启动时按 max_num_seqs × 1.2 预留好槽位,剩下的显存才给 block kv,并不会在运行时动态平衡 block kv 和 swa kv cache。调度时两边都分得到才放行。
对于 CSA kv cache,会放到 3FS,而 SWA kv cache,只在本地主机内存(每个请求 20 层 × 134 × 528B ≈ 1.4MB),而且只在 128 的整数倍位置落一份快照。Entrypoint 维护一个目录记录快照在哪台机器,跨机命中就走 400G VLAN 拉回来。
这两者有概率不同步的时候怎么办(比如 block kv 命中了,但 SWA 快照没了),原则是:命中长度由 block kv 决定,最后一块要不要重算由 SWA 决定。近似 SWA一下,说白了有损一下。
I/O
请求到来后,首先在 entrypoint (也就是ds 的 gateway?)上查询元数据,用哈希链做前缀匹配,算出命中长度,这一步要在路由前做完,因为要用这个做后面的 compute quota 吧。然后命中的时候,先在另外一个进程里把 kv 从 3FS 异步拉到本机 shm,然后在 engine 进程内的线程里从 shm 换入到 HBM,这里的 i/o 是 layer wise 的,和前向计算重叠。
关于 I/O,精华是这句,换入从 shm 到 HBM 在 engine 进程内的线程里做,目标是实现逐层 H2D (Host-to-Device) 传输与前向计算重叠,由于 CUDA copy engine 对于 KVCache Block 细粒度的拷贝性能不佳,换入使用 GDR 实现,用 RDMA 网卡就能打满 PCIe 带宽,并且不占 SM。
在 GB300 上测了一下 swap-in 的几种做法,shape 用的是 DSV4.1 的 block kv,一个 block 一层是 22,784 B,命中 64K token 就是 512 个 block,源和目的地址都是随机分布的。
搬 kv 大概有四种方式:
- copy engine 逐个拷:每块调一次 cudaMemcpyAsync,每次拷贝是一个独立的 DMA 操作,不占 SM。
- copy engine 批量拷:cudaMemcpyBatchAsync(CUDA 12.8 之后才有),一次调用把一批拷贝交给 copy engine,也不占 SM,但 batch 大小要控制,CPU 提交也有开销。
- SM gather:写个 kernel,用 SM 直接读 host 内存再写到显存,不走 copy engine,要占 SM,而且和前向的 kernel 在同一个 GPU 队列里。
- GDR:网卡做 RDMA write,从 shm 直接写到显存,不占 SM,换入线程也不调 CUDA API,只和网卡打交道。当然这里用的是一个 100gbps 的网卡。
前三种都要过 CUDA,第四种完全绕开了 CUDA。1、2、4 都不占 SM,区别在每次操作的固定开销,和会不会影响前向 kernel 的调度。
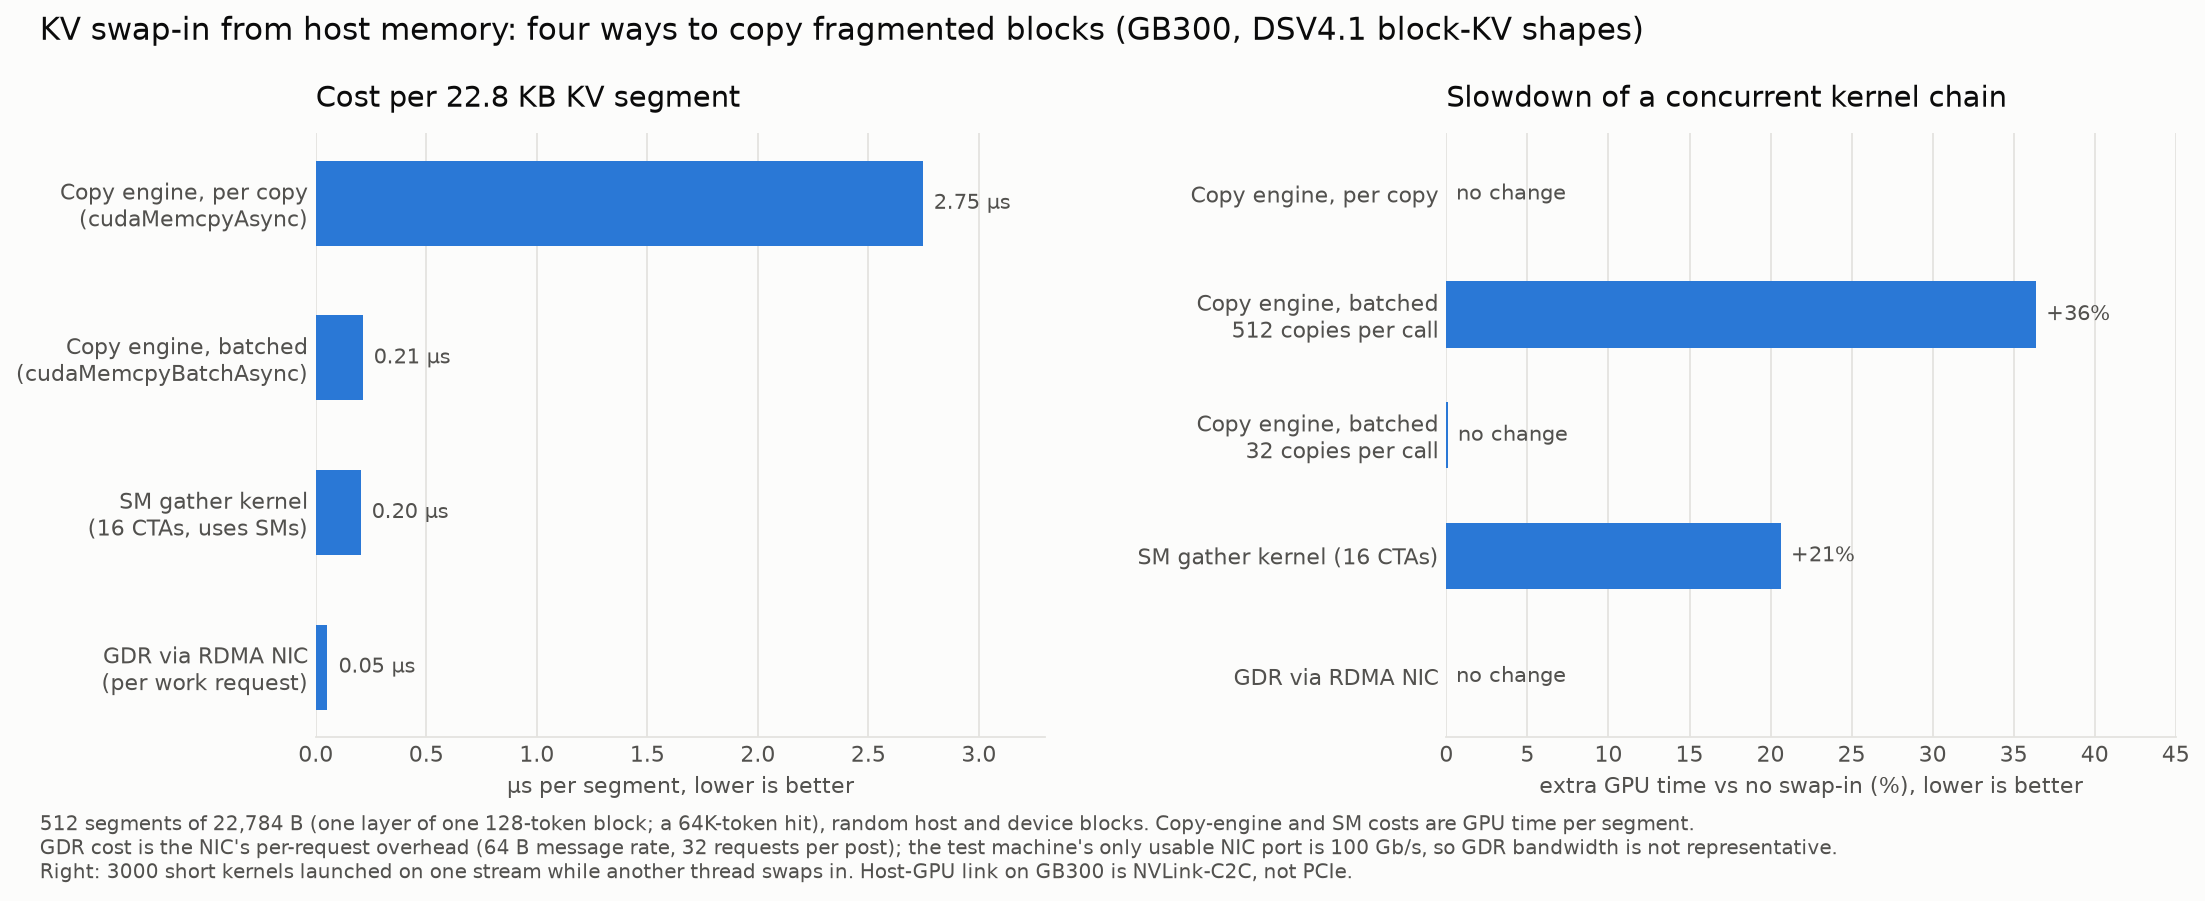
KV swap-in: four ways to copy fragmented blocks (GB300, DSV4.1 block-KV shapes)
图中左图是搬一个 22.8 KB 碎块的开销,其中 GDR 是网卡处理一个请求的开销,不含搬数据。
copy engine 逐个做,提交 overhead 巨大,CE batch 做,batch 大也影响计算,而且根据我经验来说,这东西容易 XID(猜测)。Kernel 搬运快,但是也会影响计算。RDMA 看起来提交 overhead 很小,当然性能我不知道,因为暂时没卡。如果 RDMA 性能也不差的话,那感觉就是 GDR 了。
不过链路上来说,RDMA 这有啥特别的吗?有空研究下。
EPLB:冗余换 LB
eplb 呢,就是冗余换 lb 吧。不过有个在线的 eplb,不知道开源出来没有。这里的 trade off 就是,eplb 会占用更多显存是吧,但是呢它也能提升吞吐,而且越复制收益越小,所以要找到一个比较合适的点。也是 case by case 的。
这个 Deepinfer 开源了,是在线的 EPLB。
因为是在线,所以第一步就是如何统计每个专家过去一段时间的负载是吧。首先得有一个 GPU 数组存储每个专家的 counter,DeepGEMM 开源的就是支持这个,参数名是cumulative_local_expert_recv_stats,不过默认是 None,传过去就行。
每个 rank 只有自己卡上的那几个 expert 的情况。
每个 step 算完,拷贝一份到全局的统计 buffer 里(比如窗口是 128,那就保留 128 个 step 的负载信息),拷贝完清 0,然后下一个 step 继续用。
所以我们知道了 EPLB 后,我们怎么解决呢?
-
重排:根据观测到的专家负载重新分配到各卡,不增加显存。重排又分为静态(启动时候指定好,运行时不进行改变),和动态,也是在线版。根据我的经验来说,静态收益不太大,还是得动态的。
-
冗余:一个专家的权重存放于多个卡上,decode 时可能多读权重(因为冗余了,读的总量增加了)。
- 冗余了就涉及到副本选择,当一个专家有多个副本的时候,该怎么选?
- Deepinfer 的做法
- :gate 给这个 token 选中的专家
- :专家 有几份拷贝
- :专家 的各份拷贝所在的槽位列表, 就是第 份拷贝的位置
- :这个 token 所在的卡号,用来错开起点
- :这个 token 在本卡这一批里的序号,就是报数
- :一个质数,作用是打乱报数顺序
- :算出来去第几份拷贝,取值
用自然语言来说比较简单:同一个卡上的token,热门专家有几个拷贝,就按几个一组循环分,“1,2,1,2”,这样分即可。然后不同卡,通过 rank编号,选择不同的起点。rank 之间不进行沟通。
ds 报告中说 prefill 每卡冗余 4 个专家,统计 100 个窗口,1000 个 step 更新一次,中间 900 步的统计会被覆盖,重排只看最近 100 步。decode 冗余 1 个专家统计 1000 个窗口,10000 个 step 更新一次。按时间频率,大概估算就是,两边大致都是每十分钟触发一次。
重排的时候是同步的,如果是同一个 nvlink 内,就走 nvlink,跨 nvlink,走 nccl 的 batch_isend_irecv 点对点收发。
重排的问题是:在给定worker + 专家槽位的前提下,怎么放置专家,才能让观测窗口里的每一步的“最慢的那个卡”的总耗时最小。核心是削峰,而不是追求平均。每一步整个系统的速度,取决于那一秒最慢的那张卡。
第一步是解决那些“过热”的专家,因为它如果不复制的话,交给谁都压力很大,唯一的做法就是多个卡承担。
  tokens_per_expert_all_diff = tokens_per_expert + arange_logical * 1e-4
  for i in range(num_redundant_experts):
      score = tokens_per_expert_all_diff / logical_count  # 当前每份负载
      score_added = tokens_per_expert / (logical_count + 1) # 假如多给1个副本后的负载
      values, indices = score.max(-1, keepdim=True)       # 找出每一步的“最惨第一名”
      values = values.expand_as(score).contiguous()
      score.scatter_(-1, indices, score_added.gather(-1, indices)) # 把第一名换成它减负后的值
      values.scatter_(-1, indices, score.max(-1, keepdim=True).values) # 算新的第一名
      redundancy_indices = values.sum(0).argmin(-1)       # 选总分最低的专家
在选好复制谁后,下一步就是把专家派发给各个卡了,这又是一个放置问题,本质是个装箱问题,DeepInfer 这里采取的是类似 Best Fit Decreasing 的策略:按负载从大到小依次放,每份都试遍所有没装满的卡,放到“每步最忙卡负载之和”最小的那张。先把热专家处理了,闲专家填补缝隙。
使用 DeepInfer 在 2 台 GB300(8 卡,EP8/DP8)上跑了一下:SWE-smith 真实 agentic prompt(p50 约 7k token),离线 generate,greedy 固定输出 1024 token,c512(每 rank 64 并发)。V4.1-Flash 是 384 专家 top-6,EP8 下每卡 48 个专家。
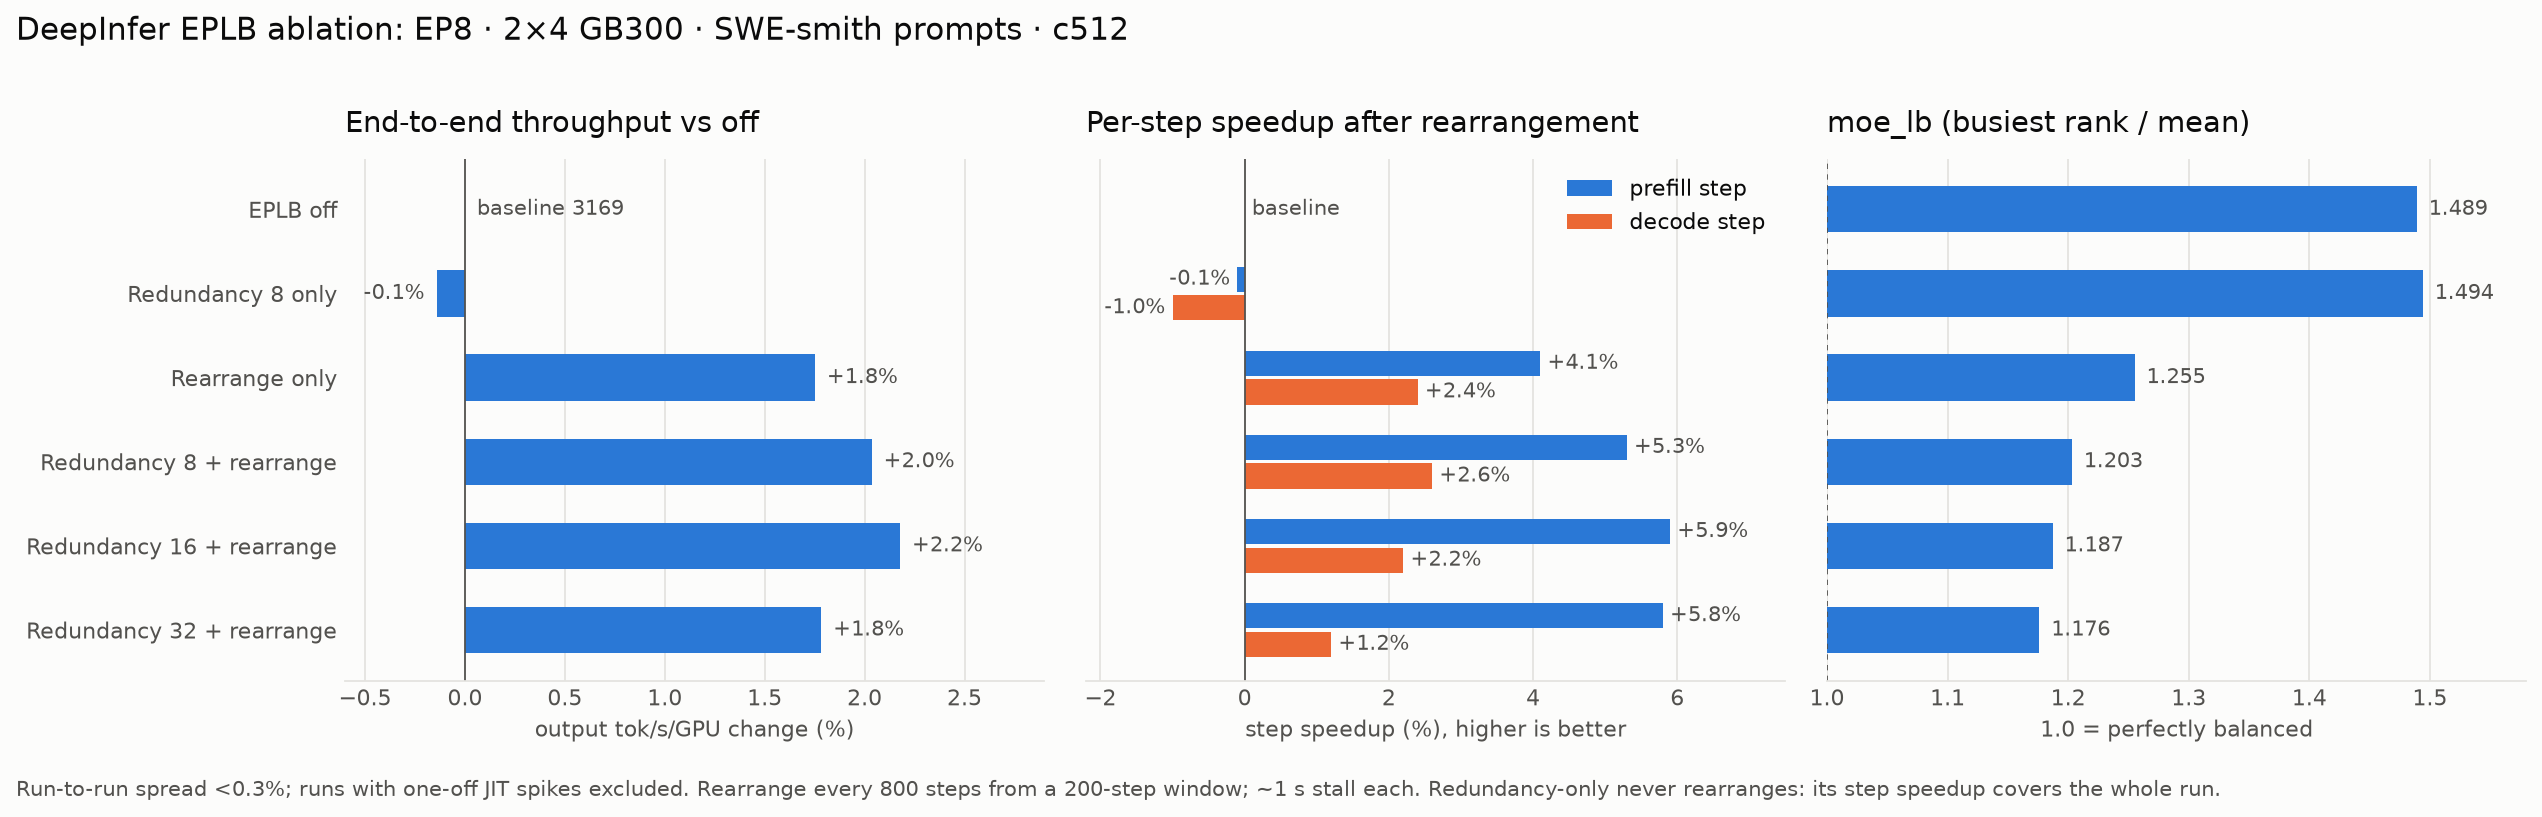
EPLB ablation: redundancy × rearrangement (rearrange every 800 steps, 200-step window)
端到端快约 2%(3169 → 3233 tok/s/GPU),收益几乎全来自重排:只重排不加冗余已经 +1.8%;只加冗余不重排反而略亏(多出来的槽位只是多读权重)。
Load balance:核心是DPLB
根据前文说的,无论 prefill 和 decode 其实都是 DP+EP,无非是谁 EP 组更大在解决 EPLB 后,剩下的问题就是 DPLB 了。
因为在 DP+EP 架构下,所有卡每一层都在反复经历 “各干各的(DP) 凑一起干(EP) 各干各的(DP)” 的同步循环。
如果不同 DP rank 计算各自 batch 的 attn 部分时候时间有差异,先算完 attn 的 rank 就需要等待最慢的那个 rank,大家需要一起同步开启 MoE 的all to all。
而 Prefill 和 Decode 负载下,attn 部分的耗时估算的公式不同,表明上是 Prefill LB 和 Decode LB,实则都围绕着 DPLB 展开。
他们文章里最后这句话很有意思,他们是这么评估负载均衡的,说达到了完全均衡的离线 benchmark 80% 的水平。
Prefill Load balance
请求先按总长下文分4 个桶(<16K、1664K、64256K、≥256K),因为所有机器都共享3FS 全局存储,所以请求在桶之间迁移(上下文增长的时候)也不会造成 cache hit 的降低。
分桶的意义在于不同上下文比例下,attn 和 moe 的比例不同,因为 attn 和上下文长度并不是线性关系,随着上下文增长,同样 的 1k token,500k 的 ctx 要算的就是比 10k 的 ctx 慢一些。
引擎会在桶之间根据负载进行迁移(因为都是 prefill worker),只不过每个桶有自己的单 batch 算力配额上限。
每个引擎有一个成本估算器,cost(q,c) ,用于估算compute_quota,这里 quota 约束的是 attn 耗时,而非整个 step 耗时。
DP 组之间,引擎自己根据待处理请求,和自己的 compute quota 剩余情况自行拉取,不做任何的 cache aware。所以这里是 pull based。
我猜想大体可能是基于一个消息队列,每个 tier 一个消息队列,然后引擎去消息队列里 拉取请求处理。
DP 组里就就是 least compute quota 去派发任务。
dp group 直接用 compute tokens 作为负载 平衡的指标,dp 组内,也是。这个有点什么的味道,我想不起来了。可能和 hash 那边的一些东西有关,maybe 是,bitmap 什么的,我只是说思想好吧。
DP 调度器并不是 fixed chunk size,而是根据“时间预算”(根据 DualPath,这个是 300ms)去组 batch 的,同时还会在 DP 组内再次 all reduce min 收紧。
fifo,这里有个有意思的,它也做了一个估计器,其实前不久我也做了一个(只不过链接失效了hh),我当时是想给 pp 做的,但是我觉得无论 ep pp,这个思路是一致的,不固定 chunk size,然后固定“耗时”,总之就是一个离线你先跑出来嘛,然后给个表,然后让 scheduler 去估到合适的时间,组 batch。
其实 Dual Path 也聊了一下 Prefill LB的,但 DS 这里没有引用,实际上调度算法差异也有点大。给读者一个思考的空间为什么。
Decode Load balance
decode 和我想的也差不多,就是一个 kv cache + num running 的组合是吧。当然具体怎么调配就是一个 case by case 的事情。
Decode 不进行分桶,同时尝试平衡两个维度,batch size 的请求数(gemm 相关算子),kv cache 长度(attention 相关算子),其实本质也是某种 cost。具体策略就是,把短请求发到并发低,但总 kv cache 长度大的 GPU(填 bs 维度),长请求发到总 kv cache 小的 GPU。
根据 DualPath,来说对于不同的 DP 组,DP 组之间用 total tokens 去平衡。然后DP 组内,先算一个kv cache平均线,然后平均线上放宽 5%, 在不超过这个线的前提下,选请求数最少的。如果都超了,那就选 kv cache 最少的。
Vision Encoder
由 P 随机选一个机器,然后机器内部自己把图像交给活最少的 worker.
PD 动态扩缩容
然后是 router 的pd 动态扩缩容,prefill 还是 整体compute tokens,deocde 是 num running,也就是系统整体的 batch size。
DSpark 动态验证
dspark 有个 confidence head,预测每个 draft token 的接受率。大 bs 下固定投 5 个去 verify 成本很高,所以根据接受率和离线 profile 的吞吐曲线,动态决定每个请求 verify 几个。
每步 verify 的 token 数从 5 降到 3.24.4,平均接受长度基本不变(3.29 vs 3.20),生产工作点(EP64,每 rank 约 60 并发)吞吐 +47%。96 并发 +11%,16 并发 -1.5%。感觉不错。