在 agent 时代如何快速验证 kernel 对精度的影响
文中讨论的一部分已经在 kern 的 kern test 中实现。
随着 agent 逐步接管 kernel 优化,kernel 如洪流一般交付的时候,一个新优化好的 kernel 接入模型后,对整体精度的影响怎么快速评估?这次替换可以 merge 吗?在传统做法里,我们一般都是拉起模型,跑一些 GSM8K 之类的测试集,设定一个阈值,比如不低于 85 分,就算过。
但是比如对于 K3 这样一个 1.4TB 的模型来说,拉起权重,再加上框架层面经常有的 autotune、JIT 什么的,e2e 启动服务可能就需要 20 分钟,再跑一个 GSM8K 加其他数据集,可能又需要 20 分钟,而且这期间至少要占 8 张卡。一次验证 30 分钟起步,我个人认为是比较低效的。
测试 kernel 对精度的影响,就像代码覆盖率一样:我们不可能达成 100% 的代码覆盖率,同样也不能实现 100% 的精度覆盖。代码也不存在 Lean 那样的校验,即使有 Lean,规约本身也可能有问题。所以问题首先不是测试能否覆盖所有 bug,我觉得对于所有软件来说,这都是不可能的。
所以我们需要回到测试的第一性原理:我们为什么需要测试?如果代码不再变更,且此时观测不到 bug,那么测试的价值就是 0。但我们需要持续交付代码改动,需要在持续更新的过程中维持对「正确性」的把握:所有测试通过后,我可以有 90% 的信心合入这个 PR 进行发版。
测试是某种「经验主义」,根据过往的 bug 经验,去防御新代码里可能出现的问题。比如评论区有人说 round 有问题,说明根据他的经验,他隐约意识到这里可能有点问题,那我们就深入研究,然后写下一个能合理覆盖它的测试。就拿推理优化的 kernel PR 来说,我想防御的是错误的舍入和误差的累积(同样的误差出现在不同地方,代价不同)。
拉起来跑 GSM8K 等数据集,没问题,从交付角度来看,它代表了最终交付给用户的体验,但它贵、抖、无法归因。端到端的红无法区分 PR 引入的退化和数值抖动,红了也不知道去哪查,如果你给这些引擎贡献过 PR,应该有类似的体验。我们能否用更小的代价完成这个测试?我想要的是:在 GSM8K 飘红的时候,我的测试也不会给绿。我可以假阳,不可以假阴。这个目标能保证到什么程度,后面「和 GSM8K 的关系」一节会讲。
同时因为批次不变性并不成立,e2e 测试时 GSM8K 的波动也无法准确定位。我始终认为 logits 才是我们应该看的,因为模型本质输出的是 logits,而不是采样后的 token。我更希望对比 hidden 和 logits,从信息论的角度来说,它们也包含了更多信息。
《Accuracy is Not All You Need》说了很多我想说的,当然它主要测的是量化:即使在某些数据集上准确率没有变化,测试的数据集也不等于用户的数据集;同时翻转可能刚好让一些本该错的题莫名对了。交付的还是同一个模型,但对于用户来说,在某些数据上,它已经大变样了。
先要有一个 ground truth
一切的根本,是一个 ground truth 推理方案,哪怕很慢。一般来说它是有的,不然模型是怎么训出来的:模型厂商通常会提供参考推理脚本,比如 Hugging Face 上的 modeling 代码,或者随权重一起发布的 inference 实现。它定义了这个模型「应该」算出什么,拿 f32 跑,慢一点也无所谓。
只和上一版比是不够的。每个 PR 都在阈值以内,十个 PR 叠起来可能已经偏得很远。每次都和 ground truth 比,误差就不会随版本悄悄累积。
ground truth 只需要跑一次:在语料上录下它的分布存成文件,之后每个 PR 只跑自己的输出,不需要每次都跑 ground truth,除非它自己有更新。
看 logits,而不是 token
模型本质上输出的是 logits,是一个分布,token 只是从分布里挑出来的一个结果。只比 token,会漏掉大部分变化。
举个例子。下一个词是什么动物,基线认为猫 55%、狗 30%、狐狸 8%;候选实现认为猫 52%、狗 16%、狐狸 24%。两边挑出来的都是「猫」,逐 token 比完全一致,但狗和狐狸的概率已经对调了一大半。
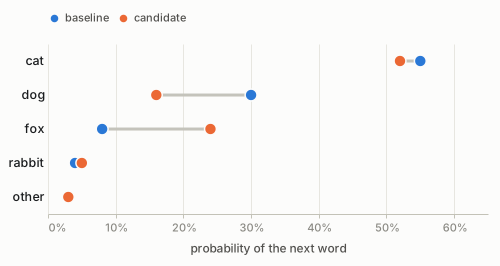
所以要直接比分布。做法是 teacher forcing:把同一段固定文本喂给两边,在每个位置记下各自预测的下一个词分布。输入固定,结果就是确定的,任何差异都能对应到具体的位置。
怎么比两个分布
比分布用三样东西:KL、翻转、margin。
KL 衡量两个分布整体差多少,0 表示完全一样:
上面猫狗的例子,KL 是 0.12。作为对照,同一个模型两个都正确的实现之间,KL 通常只有万分之几,下文把这个水平叫正常差异(后面实验会测)。token 一模一样,KL 却是正常差异的几百倍。
KL 有个问题:它会把用户几乎采不到的长尾也算进去。举个例子,假设词表末尾有 10 个冷门词,每个概率 0.1%;候选把其中 5 个调到 0.15%,另 5 个调到 0.05%,总量不变。这些词加起来只有 1%,开了 top-p 之类的截断就根本采不到,但它们也贡献了 0.0014 的 KL,比正常差异还大不少。所以我们只在基线前 20 名的词上逐项算 KL,剩下的词合成一个「其他」,长尾内部怎么挪就不算了,长尾总量变了也算某种「变化」。
为什么长尾的影响能这么大?把候选的每个 logit 看成基线的 logit 加一个小误差 δᵢ,KL 近似等于这些误差按概率加权后的方差:
单个冷门词的概率很小,但它的误差可以很大:概率越小,低精度下的相对误差越大,换到 logit 上就是一个大的 δᵢ。词一多,加起来就不小了。
top-1 翻转:候选实现的第一名和基线不一样,也就是 token 级别能看到的变化。
margin:基线在这个位置上,第一名的 logit 比第二名高多少。margin 小,说明模型本来就在两个词之间纠结。只看这两个词,margin 为 0.1 时,猫和狗的概率是 52.5% 对 47.5%;margin 为 1 时,是 73% 对 27%。
正常差异来自两个同样正确的实现之间本来就有的差别,比如只是计算顺序不同。判红的阈值至少要比它高一些,不然随便换一个 kernel 都会报红。
三者联合起来验证精度问题
翻转是否严重,要看 margin。直觉很简单:如果猫只比狗高一点点,数值噪声一推就翻了,很正常;但如果猫远远领先,反而翻出来狗,那就有问题了。假设每个 logit 上的噪声是独立的高斯噪声,大小都是 σ,把这个直觉写出来,第二名反超第一名的概率是:
Φ 是标准正态分布的累积概率,右边的上界更好看出规律:概率随 margin 的平方指数下降。假设(当然这里只是假设)噪声大约是 0.1:margin 为 0.1 时,概率是 24%,很容易翻;margin 为 0.5 时,降到万分之二;margin 为 1 时,约万亿分之一,基本不可能。这里只算了第二名,第三名以后的词也可能反超,但它们离得更远,贡献更小。
所以 margin 小的翻转多半是噪声,单纯数翻转个数会误报,要按 margin 分档,每一档的翻转率和正常差异比。margin 大的翻转在噪声下几乎不会发生,出现了就值得停下来查。
不过「大 margin 翻转」这条规则在实验里一次也没触发:精度最差的变体,在 margin 超过 1 的位置上也没有翻转。把它和正常差异分开的,是 margin 小于 1 的那些位置上的翻转率(见后文实验)。所以它更像一条兜底的规则,能抓到什么样的 bug 还没验证。
语料要又深又长
误差有两种长法。一种会沿着 decode 一步步传下去,比如每步都要更新、一直往后带的循环状态,越往后越大,前十几步几乎看不出来。另一种不会传到下一步,但和上下文长度有关,比如注意力权重的舍入,上下文越深越大,短 prompt 上几乎看不出来。
所以语料两头都要覆盖:decode 要足够多步,上下文要足够深。后文实验里两种各有一个具体例子。
语料里还要有足够多的散文。代码可预测,大多数位置的分布很尖;但代码里那些拿不准的位置和散文一样敏感,只是这种位置少。散文里拿不准的位置多,同样长度的语料能测到更多。
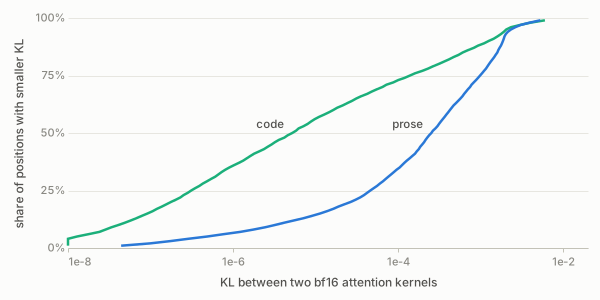
perplexity(困惑度)看不出这一级的差别
perplexity 只看原文那个词的概率,把整个分布压成了一个数。实验里精度明显变差的几个变体,KL 都能和正常差异分开;perplexity 的变化却和抽样噪声一样大,连谁更差都排不出来。
和 GSM8K 的关系:只有一个很松的上界
数学上能保证的是:如果 GSM8K 的准确率变了,那么在基线自己会采样出的回答上,逐步的分布一定也变了。前提是 GSM8K 用采样解码,温度、top-p 和算 KL 用的分布一致;贪心解码下两边的输出都是确定的,这个结论不成立。
具体来说,准确率在 0 到 1 之间,新旧两个模型的准确率差距,不超过它们生成的整段回答分布之间的距离(全变差距离),而这个距离又被逐步 KL 之和管住:
全变差距离可以理解成:把一个分布变成另一个,最少要挪动多少概率。猫 60%、狗 40% 变成猫 50%、狗 50%,要从猫挪 10% 给狗,距离就是 0.1。这里的 KL_t 是第 t 步的 teacher forcing KL,严格说是对基线自己采样出的前缀求平均,一段固定的语料只相当于其中一次采样。所以语料里应该放基线在目标任务上的输出,比如它给 GSM8K 写的解题过程。
但这个上界太松,拿来定阈值没有意义。代入看:一段 500 步的回答,每步 KL 都只有正常差异那么大(平均约万分之 7),右边已经是 0.4,也就是允许准确率差 40 个点;反过来,准确率掉 2 个点,只要求每步 KL 平均超过百万分之 1.6,远小于正常差异。所以只要阈值定在正常差异之上,「GSM8K 红则 logits 必红」就不是定理了。
阈值只能靠经验标定:把历史上出过精度问题的版本回放一遍,看它们在 KL 和翻转上到什么程度,阈值就定在那里。这跟给修过的 bug 补一个单测是一回事,只是 assert 换成了分布距离。也可以自己人为制造一些精度 bug 和浮点误差,观测 KL 和翻转的变化。总之比较靠经验,没有一个放之四海皆准的固定 KL 阈值。
实验:在 Qwen3.8-27B 上动两处看不见的精度
Talk is cheap,我们来实际改造一下推理路径,人为制造一些精度问题,看看 logits 的实际反应。实验基于 Qwen3.8-27B,这是个混合模型:48 层 GDN(一种线性注意力,每层带一个循环状态)加 16 层全注意力。我们来改两处 kernel 内部的精度,它们在模型配置和接口里都看不到:
- 循环状态:每层每个头一个 128×128 的 f32 矩阵,每条序列合计约 150 MB,每步 decode 都要读写一遍。它看起来很吃精度,毕竟它是某种「压缩」的结果,我们直觉上认为它会充分利用 f32,改成 bf16 等会造成多大影响呢?我们让它每次更新后只保留 4 到 16 位尾数(f32 有 23 位),指数范围不变,排除溢出的干扰。
- 注意力权重 P:注意力的输出是 O = P·V,其中 P = softmax(QKᵀ/√d),形状是 [头数, query 数, key 数],每个元素是一个 query 分给一个 key 的权重。flash attention 一类的 kernel 不把 P 写回显存,只在寄存器里一块块算出来,转成某种精度后直接和 V 相乘,最后才除以每行的和,所以舍入的是 exp(s − 当前最大值),取值在 0 到 1 之间。原实现用的是 TensorRT-LLM 的 trtllm-gen FMHA kernel,只发布二进制。我们写了一个朴素的注意力 kernel 替换它,P 可以保持 f32,也可以转成 bf16、fp8,或者先乘 448 再转 fp8。
注意力实验以「P 保持 f32」的朴素实现为参考,循环状态实验以原实现(f32 存储)为参考。两者都不是厂商脚本,只是近似参考:除了被替换的那一处,其余部分和生产用的 bf16 实现完全相同。
语料全部是公开文本:代码取自 CPython、FlashInfer、Tokio、flash-linear-attention,散文取自 Project Gutenberg 的 8 本书。上下文 2k、8k、32k、64k、128k 各 4 段,每段末尾 512 个 token 逐个 decode 打分,共一万多个位置。运行是确定性的,同一实现跑两遍逐位相同。
正常差异有多大
实验里最小的两处改动,散文上的 KL 中位数都在万分之 2.5 左右:一处是循环状态每次更新后只保留 16 位尾数,另一处是朴素注意力里把 P 从 f32 舍入到 bf16。同一个实现跑两遍则是 0。我把这个水平当作正常差异,比它小的差别,在 KL 中位数上分不出来。
这两处改动本身的大小差了几百倍:保留 16 位尾数,相对误差在十万分之一量级;P 舍入到 bf16,相对误差在千分之几。KL 却一样。原 kernel 和朴素实现同为 bf16,两者之间也是这个量级。
单独看一段 prompt 也是这样:P 换成各种精度,第一层注意力的输出误差前后差了二十倍,到最后的 logits 都在 2% 左右。
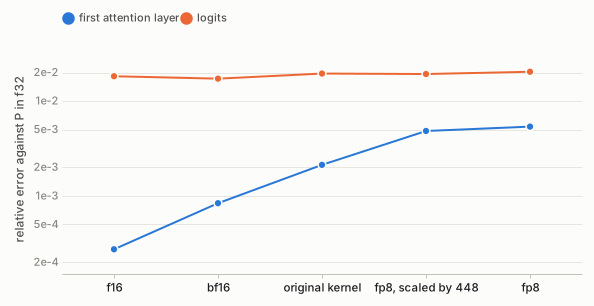
我只试了这两处,别的微小改动是否也落在同一水平没有验证。我的推测是:模型里的激活都是 bf16,一个微小的变化只要让某个激活越过 bf16 的舍入边界,就会放大成一个 bf16 的最小单位,再一层层传下去。循环状态的实验里看得到这种放大:
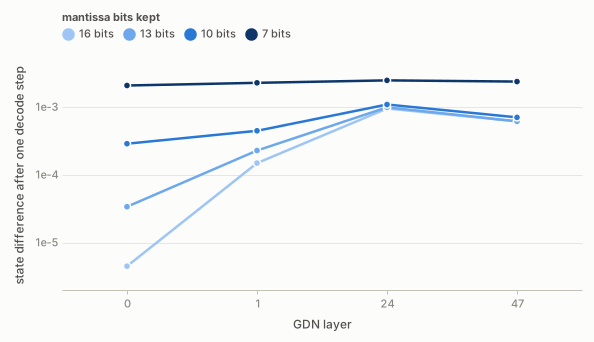
第 0 层的输入是词向量,不受别的层影响,它的差别基本就是舍入本身,按位数分得很开。从第 1 层开始,上游的变化通过 bf16 激活传下来,到第 24 层,16、13、10 位已经分不开,都在千分之一左右。只留 7 位的舍入本身就有千分之二,比放大后的水平还大一点。
循环状态:用 f32 存,实际只有约 bf16 的精度
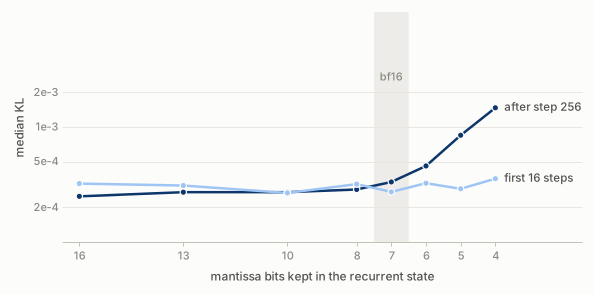
KL 开始上升的那一档(下文叫拐点)落在 bf16 附近:直觉错了,这块状态并没有用满 f32。
源码里看得到原因。Qwen3.8 的 prefill 用的是 vLLM 里 FLA 的 Triton kernel(chunk_delta_h.py):状态本身一直以 f32 留在寄存器里,但每 64 个 token 算一次增量时,先把状态转成 bf16 去和 w 相乘(v_new = v − w·h),v_new 也转成 bf16,再累加回 f32 的状态。所以状态虽然是 f32 存、f32 累加,每一块增量却只有 bf16 的精度,后 16 位比误差还小,算得再细也没有意义。
K3 用的 FlashKDA 更直接:跨 chunk 的状态就放在 bf16 的 shared memory 里。接口上传进传出的是 f32 状态,kernel 只是在开头把它转成 bf16、结尾再转回 f32,后 16 位尾数全是 0。
我也直接量了一下:同一段约 2k token 的散文 prompt,一种是 prefill 时一次全部喂进去,另一种是每次只喂 512 或 64 个 token、分几次喂完,数学上两者结果应该完全一样。在 decode 的同一步比较状态,两种喂法只有大约 7 位尾数一致,和源码对得上。不过分次喂也改变了其他算子的形状,比较又是在 decode 若干步之后做的,全模型 bf16 激活的放大(见上一节)也混在里面,这几个来源我没有分开。
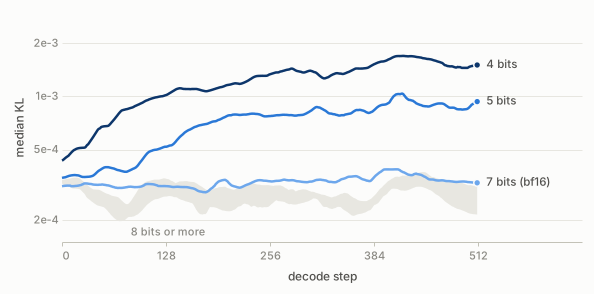
decode 的 kernel 全程用 f32 更新状态,原实现在 decode 阶段不再引入 bf16 误差;改成 bf16 存,每一步都会多一次舍入,误差随步数累积。所以在 512 步以内,把状态改成 bf16 存代价很小,能省一半显存和带宽;更长的 decode,比如几千步的推理链,我没有测,不能说没有代价。
这也是一个找看不见的精度的通用办法:不用读 kernel,一档一档砍某个张量的位数,拐点就是它实际用到的精度。
这里还有一个例子说明语料为什么要够深。2k、8k 的 prompt 一次 prefill 就能吃完,状态在 prefill 内部从不经过存储,所以 prefill 最后一个位置的 KL 正好是 0;32k 以上的 prompt 要分几块 prefill,块与块之间状态要存一次,舍入才开始起作用。只用短 prompt,prefill 里的这类问题根本测不到。
注意力权重:直接转 fp8 随上下文变差,先放大就和 bf16 差不多
几种变体用的是同一个朴素 kernel,只有 round_p 不同。一行 query 的计算大致是:
def attention_row(q, K, V, round_p):
    m, l, o = -inf, 0.0, zeros(d)            # 当前最大值、行和、输出,都是 f32
    for Kb, Vb in blocks(K, V):              # 一块块扫过所有 key
        s = q @ Kb.T / sqrt(d)
        m_new = max(m, s.max())
        p = exp(s - m_new)                   # 还没归一化,取值在 0 到 1 之间
        l = l * exp(m - m_new) + p.sum()     # 行和用没舍入的 p
        o = o * exp(m - m_new) + round_p(p) @ Vb   # 只有乘 V 的这一下用舍入后的 P
        m = m_new
    return bf16(o / l)

round_p = {
    "f32":                lambda p: p,
    "bf16":               lambda p: bf16(p),
    "fp8":                lambda p: e4m3(p),              # 直接转,小于约 0.001 的变成 0
    "fp8, scaled by 448": lambda p: e4m3(p * 448) / 448,  # 先放大再转,用完除回去
}
q、K、V 本身都是 bf16。
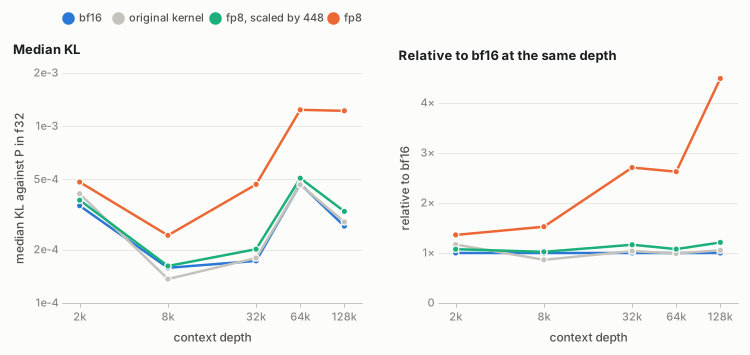
左图里 bf16 自己也随深度上下起伏,因为每个深度用的是不同的书;右图除以同一深度的 bf16,把这部分消掉了。样本不多:每个深度只有 2 段散文,同一深度的两段之间也能差不少,所以只能说 fp8 大致随上下文变差。
我认为原因是下溢。fp8(e4m3)能表示的最小正数约是 0.002:比它一半还小的权重直接变成 0,接近它的也只剩一两位有效数字。上下文越长,注意力摊得越薄,落进这一段的权重越多。先乘 448(fp8 能表示的最大值),这条门槛就降到了百万分之几。丢掉了多少概率质量,我没有直接测。
这也说明只看单个 kernel 的误差不够。先乘 448 的 fp8 在第一层的误差是 bf16 的五六倍(上一节的图),端到端却和 bf16 差不多;直接转 fp8 的局部误差只比它大一点,端到端却随深度变差。我猜误差往哪个方向偏比大小更要紧:下溢总是往 0 舍,丢掉的概率质量会层层累积;先放大再舍入的误差有正有负,能互相抵消。
我读到的开源 fp8 注意力实现都会先放大再转:TensorRT-LLM 的 XQA、FlashInfer 的 fp8 路径乘 448,fmha_v2 和 FlashAttention-4 乘 256。我只测了 448。trtllm-gen 的 fp8 kernel 只有二进制,它怎么做的我没有验证。
原 kernel 端到端和朴素 bf16 几乎一样,各深度相差不到两成。在第一层注意力上用同样的输入单独比输出,prefill 时它相对 f32 的误差和朴素 bf16 相同,decode 时大约是 2.5 倍,原因在二进制里,我没有查。所以至少在 prefill 上,原 kernel 就是「P 转 bf16」。
margin 和翻转
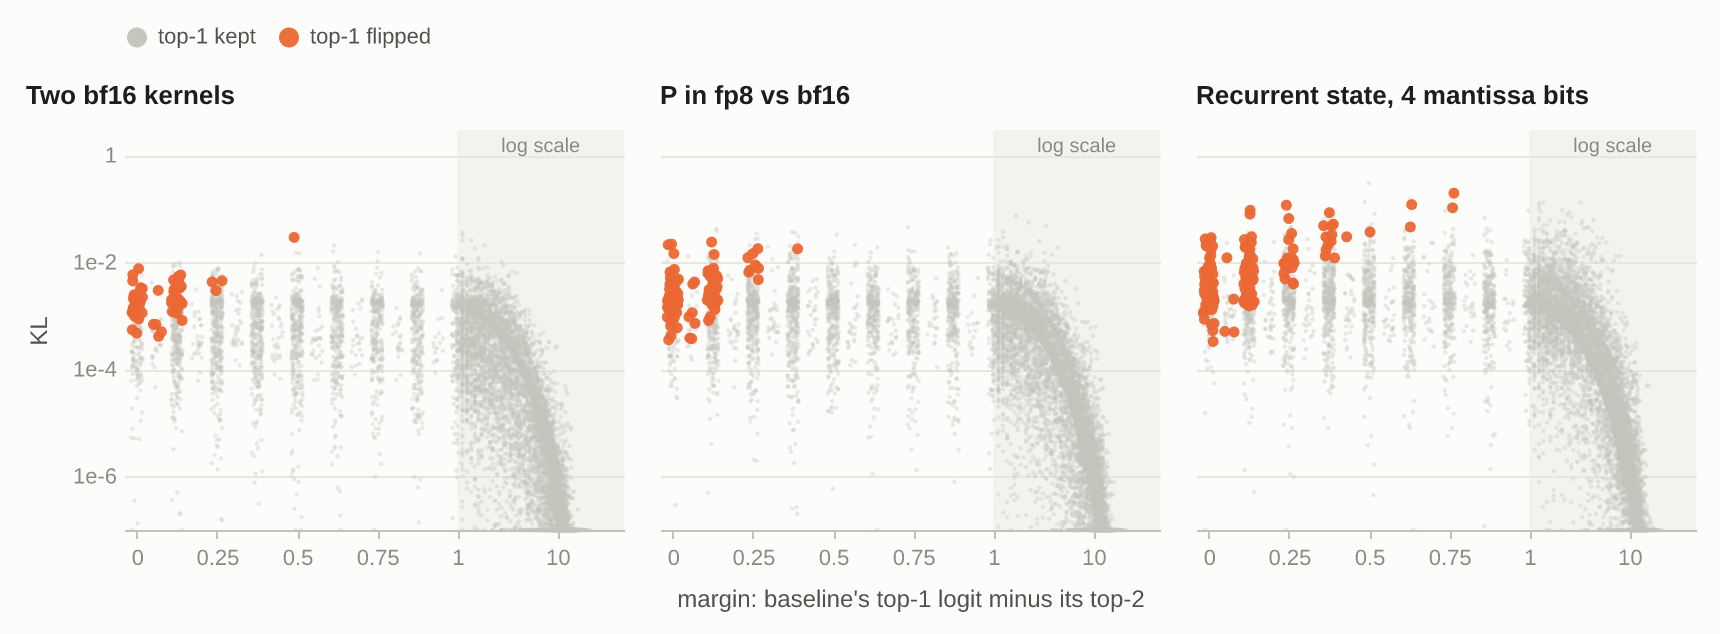
三张图的形状几乎一样:基线越确定,分布变得越少,margin 到 10 左右 KL 几乎为 0。第一名被换掉只发生在基线本来就拿不准的地方,三张图里都没有越过 margin 1。
所以精度变差,不表现为把有把握的答案改掉,而是在拿不准的位置上换得更多。按 margin 分档数一下翻转率:
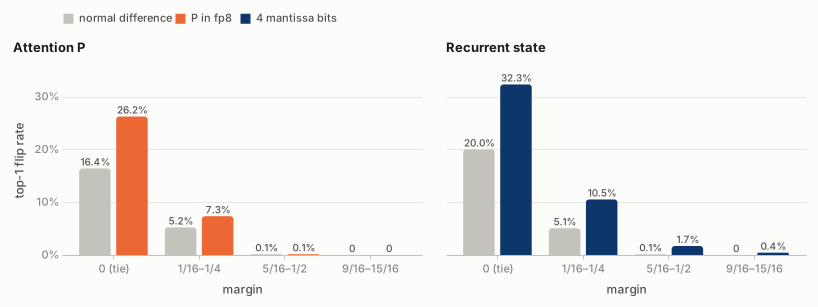
只留 4 位尾数在每一档都和正常差异分得开;P 转 fp8 分不太开,这种程度的变化要看 KL。
反过来,KL 很高的位置九成以上没有翻转。只比 token,这些变化全都看不到。
只看生成的 token 会怎样
同一段 2.5k token 的 prompt,各变体贪心生成 256 个 token,和「P 保持 f32」比,看第一个不同的 token 出现在哪:
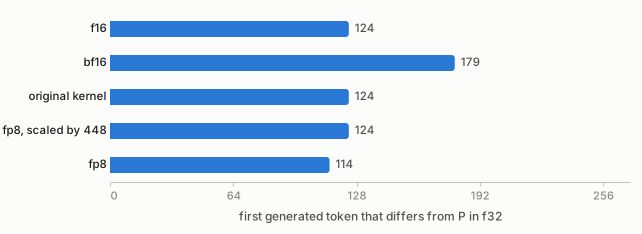
精度更高的 f16 反而比 bf16 分叉得早,和先乘 448 的 fp8 同时分叉。分叉点集中在同几个第一名、第二名几乎平局的位置上,谁先分叉取决于噪声在这些位置往哪边推,和精度高低无关。这只是一段 prompt 上的例子,但它说明了为什么不能只比 token。
附录:公式的来历
翻转概率:把第一名和第二名的 logit 误差各看成标准差为 σ 的独立高斯噪声,两者之差的标准差是 √2·σ,翻转就是这个差超过 margin,概率是 Φ(−margin/√2σ);右边是高斯尾部的标准上界。被第三名以后的词反超没有算进去,严格的上界要对它们逐个加起来。
GSM8K 上界:整段回答的 KL 等于逐步 KL 之和,每一步对基线自己采样出的前缀求平均(链式法则);Pinsker 不等式把全变差距离限制在 KL 一半的平方根以内;0 到 1 之间的指标,在两个分布下的期望之差不超过全变差距离。准确率是对多道题求平均,这时根号里放的是各题 KL 的平均(Jensen 不等式)。