CUPTI HES:Blackwell 上用硬件采集 kernel 时间戳
相关代码见 pegainfer-project/kern。
Google SRE 那本书里提到,观测系统有几个方面:
- 延迟
- 流量
- 错误
- 饱和度
前三个引擎已经做得很好了,GPU 利用率这个很难观测,比如 nvidia-smi 几乎都会给 100% 利用率,或者温度,或者功耗,都不是一个贴合“业务”的指标。
即使抛开 SRE,我们日常开发测试也会有这些问题:
如何高效观测线上时间花在哪里?虽然我们可以离线 replay,模拟很多线上流量,但真正上线后,kernel 耗时,包括 expert 的激活什么的,都有可能变化。我们希望快速、有效地知道线上 kernel 耗时的分布,也包括 kernel 之外的时间,比如 GPU 有空泡。
同时当我们优化完后,离线优化是否能真的 feedback 回线上,我离线优化了 kernel A,取得了 3% 的收益,那我 A/B 上线,这样能直接看到线上流量下,优化版本部分 kernel A 和基线的对比。
对于 SRE 来说,最头疼的可能就是机器可能因为各种原因变慢,driver 问题,机房问题,一些硬件的静默性能回退。并且并行后,可能只是某个 rank 慢,拖慢所有 rank。正常观测 TPOT、TTFT 很难发现这个问题。可能结论只是,哦,也许流量大了。即使发现不对劲,也很难知道为什么(到底是哪里有问题),甚至确定具体 rank。包括一些 TPOT、ITL 的 P99,大规模部署,WideEP 等铺开,如何在 64 个卡里确定 EPLB、DPLB 等问题?可能是卡 SM 降频了,可能是 NVLink 变慢了,怎么排查呢?
区分是流量变了还是系统变了,TPOT P99 上涨,到底是流量形状变了,还是系统本身退化了,如果流量形状变了导致的,那么具体是哪部分低效呢?
我待过一些 MaaS 公司,也和一些 MaaS 团队交流过,这都是一大痛点。线上性能的可观测性、可拆解性。
在做完这篇文章里的这个 feat 后,我认为我们能得到更好的可观测性建设,甚至可以有个 Agent 进行日常推理服务的性能巡检,这都是非常解放人力的。
Blackwell 硬件可观测性:HES
https://docs.nvidia.com/cupti/13.4.1/main/main.html#hardware-event-system-hes
当然这个要是好做,前人早做了,轮不到我摘这样的低垂果实了。但很少有人注意到 Blackwell 架构引入了一种硬件级别的可观测手段,叫做 Hardware Event System,简称就叫 HES,用来收集 kernel 的时间戳的,它不仅测得更准,而且开销更小,包括能测 CUDA graph。毕竟人家是硬件 level 的 feat。
但它本质只是 CUPTI 的一个 flag,打开就行,打开自然就更快了。所以在正式测量 HES 对观测的改善之前,我们先介绍一下 CUPTI 是怎么运作的。
首先,这里用的 CUPTI tracing 接口是“订阅”制的,其中 Activity 的异步收集机制有点消息队列那个味道。CUPTI 常用的观测能力有几类:
- Activity API:收集 kernel 执行、内存拷贝、CUDA API 调用等活动记录,通过 buffer 异步交付,适合看时间线和耗时。
- Callback API:在 CUDA API 进入、退出,以及 context 创建、销毁等事件发生时触发回调,适合跟踪调用和资源生命周期。
- Profiling / Sampling:采集 GPU 硬件性能计数器和指标,或者用 PC Sampling 看指令位置及 warp 停顿原因,适合进一步分析性能瓶颈。
这里我们主要观测 kernel 的 activity,跳过初始化,API 比较简单:
cuptiActivityRegisterCallbacks_v2(subscriber, on_request, on_complete);
uint8_t hes = 1; // 打开,0 是关闭
size_t size = sizeof(hes);
// 开启 HES
CHECK(cuptiActivitySetAttribute_v2(subscriber, CUPTI_ACTIVITY_ATTR_ENABLE_HES, &size, &hes));
// 订阅 kernel 事件
CHECK(cuptiActivityEnable_v2(subscriber, CUPTI_ACTIVITY_KIND_CONCURRENT_KERNEL, nullptr));
主要要编写的就是两个回调函数,我们先看 on_request,这个函数作用其实比较简单,CUPTI 要占用 host buffer 写东西,它要一个空 buffer,写它的 activity 记录:
static void CUPTIAPI on_request(uint8_t** buffer, size_t* size,
                                size_t* max_records, CUpti_BufferCallbackRequestInfo*) {
    *size = 64 * 1024;
    *max_records = 0;
    *buffer = static_cast<uint8_t*>(std::aligned_alloc(8, *size));
}
对应的 on_complete 就是消费它的记录,释放刚才分配的 buffer(实际可以循环复用,不过无所谓了):
static void CUPTIAPI on_complete(uint8_t* buffer, size_t, size_t valid,
                                 CUpti_BufferCallbackCompleteInfo*) {
    // 事件的 cursor
    CUpti_Activity* record = nullptr;
    for (;;) {
        // 从 buffer 里取下一个记录,类似 iter.next
        const auto result = cuptiActivityGetNextRecord_v2(subscriber, buffer, valid, &record);
        if (result == CUPTI_ERROR_MAX_LIMIT_REACHED) break;
        CHECK(result);
        // 只看 kernel 事件
        if (record->kind != CUPTI_ACTIVITY_KIND_CONCURRENT_KERNEL) continue;
        // 这个 record 类型对了,那就可以转换
        const auto* kernel = reinterpret_cast<const CUpti_ActivityKernel12*>(record);
        // 在这里打印,或者观测
        print_kernel(*kernel);
        ++records;
    }
    std::free(buffer);
}
这个大概就是它的机制和 API,那我们到底能拿到什么 kernel 信息呢?还是比较全面的。
它完整的话,会给这么多变量:
CUpti_ActivityKernel12 {
  name = _Z11demo_kernelv
  kind = 10
  cacheConfig.both = 0
  cacheConfig.config.requested = 0
  cacheConfig.config.executed = 0
  sharedMemoryConfig = 0
  registersPerThread = 16
  partitionedGlobalCacheRequested = 1
  partitionedGlobalCacheExecuted = 1
  start = 1793791995660460091
  end = 1793791995660460411
  duration = 320 ns (end - start)
  completed = 1793791995660460411 ns
  deviceId = 0
  contextId = 1
  streamId = 7
  gridX = 2
  gridY = 1
  gridZ = 1
  blockX = 32
  blockY = 1
  blockZ = 1
  staticSharedMemory = 0
  dynamicSharedMemory = 0
  localMemoryPerThread = 0
  localMemoryTotal = 61931520 (deprecated; see localMemoryTotal_v2)
  localMemoryTotal_v2 = 61931520
  correlationId = 1
  gridId = 2
  queued = 0 (not collected with HES)
  submitted = 0 (not collected with HES)
  launchType = 0
  isSharedMemoryCarveoutRequested = 0
  sharedMemoryCarveoutRequested = 0 (not requested)
  sharedMemoryExecuted = 32768
  graphNodeId = 0
  shmemLimitConfig = 0
  graphId = 0
  pAccessPolicyWindow = 0
  channelID = 0 (not collected with HES)
  channelType = 1
  clusterX = 0
  clusterY = 0
  clusterZ = 0
  clusterSchedulingPolicy = 1
  maxPotentialClusterSize = 0
  maxActiveClusters = 0
  isDeviceLaunched = 0
  priority = 0 (not collected with HES)
  executionModel = 1
  (reserved0 and padding fields omitted; no defined meaning)
}
字段比较多,比较基本的就是,kernel 名字、start、end(都是 ns level),然后是 launch 信息、grid 信息,其他字段感兴趣的朋友可以自行查阅。
我们对 launch 信息可能不是特别感兴趣,对于我们来说什么 kernel,什么时候执行的,什么时候退出的就足够了。
HES 是进程级别的特性,必须在任何 CUDA context 之前打开,开了就关不掉。
接入效果
怎么接入的,我们放到后面,本质是一个比较工程的事情。我想先展示一下,对外的接口设计,也就是先展示一下产品本身。
简而言之,HES 开启后,我们可以持续拿到每个 step 的 kernel 拆解,无论是 prefill 还是 decode,比如 decode batch 33 ms 的话,1 s 中能产生 30 个 batch 的拆解,一次 decode forward 可能包含数千个 kernel launch。这些持续的数据我们怎么存储,怎么展示?
For SRE
站在 SRE 的角度,就像 Google SRE 那本书里说的,SRE 分为两部分,一部分是“症状”,如果系统生病了,我们能不能观测到,以什么复杂度观测到,另一部分是“根因”,就是系统生病了,我们能否快速知道根因是什么,病灶是什么。
前者我们选择了几个 counter:
kern_device_seconds_total:把 GPU 时间拆分为三类,compute、comm、idle,其中 comm 是 kern 可以从 manifest 里推断出来的,要么是 NCCL kernel(kern 内置),要么是用了 peer buffer 的(比如 MegaMoE,和一些通算融合)的 kernel,idle 就是空闲时间,在一个时间窗口内,减掉 GPU busy 的时间。kern_step_compute_seconds_total:每个 step 的耗时,按 program 分开,program(这个是 kern 的概念),简单理解为 prefill 和 decode forward 吧。其次进一步地按 bs 和 KV cache 再粗粒度分一个桶(因为比较 bs1 和 bs128 的 decode batch 耗时意义不大),prefill 也是。kern_steps_total:运行的 step 数。kern_trace_dropped_records_total:防止 CUPTI 丢记录。
同时我们会后台异步落盘每个 step 的 kernel 耗时,30 分钟落盘一个 Parquet,也提供了一个 HTTP API,可以提前触发 flush。有了这些非常详细的 Parquet,你可以借助 Claude Code 让它用 DuckDB 等进行细粒度的性能分析工作。
那么 SRE 可以拿到什么看板呢?我们拿一个 DP4 EP4 的 DSv4.1 Flash 看,跑了一个 agentx 的 workload。
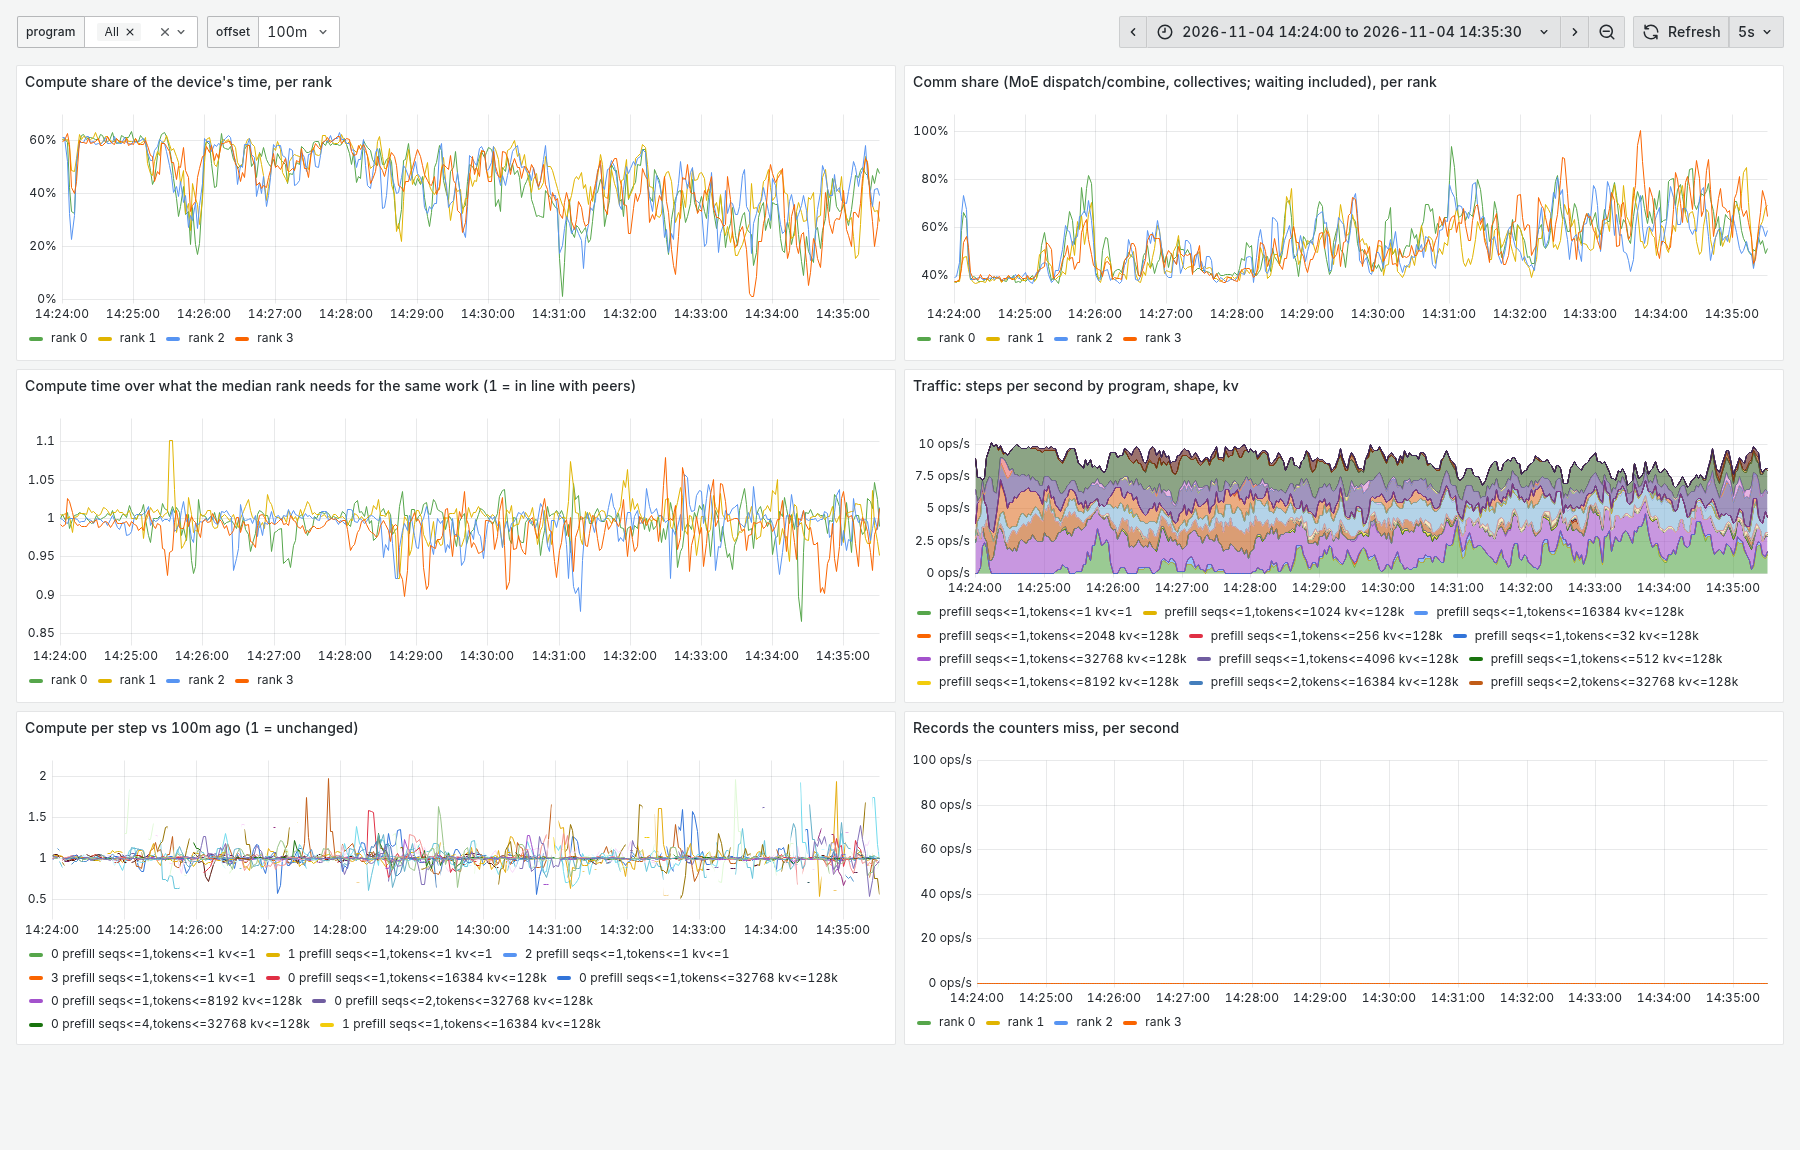
第一行就是 compute 和通信各自占据的耗时,随着负载进入稳定阶段,decode 阶段,通信占比逐渐爬升,因为这里是 Mix 混合,如果是 P/D 分离,可能有更有意思的曲线。
第二行左图是大家计算的健康性,算一样的东西,大家是不是差不多快,基本在 1–1.1 之间,有一些小波动,但整体来说没有太大问题。
第二行右图:它在跑什么 batch,我觉得这个很直观,很漂亮。
第三行左图就是每步 compute 对 100 分钟前那一轮(比值,平时贴着 1),右图就是 CUPTI 被丢掉,为 0,符合预期。
那么现在看过正常的了,我们来模拟一个不正常的。我们在 rank 2 的卡上,时不时算个 GEMM,影响 rank 自身的计算,模拟卡坏了,或者有什么问题。我们来看,这样之后看板是这个样的:
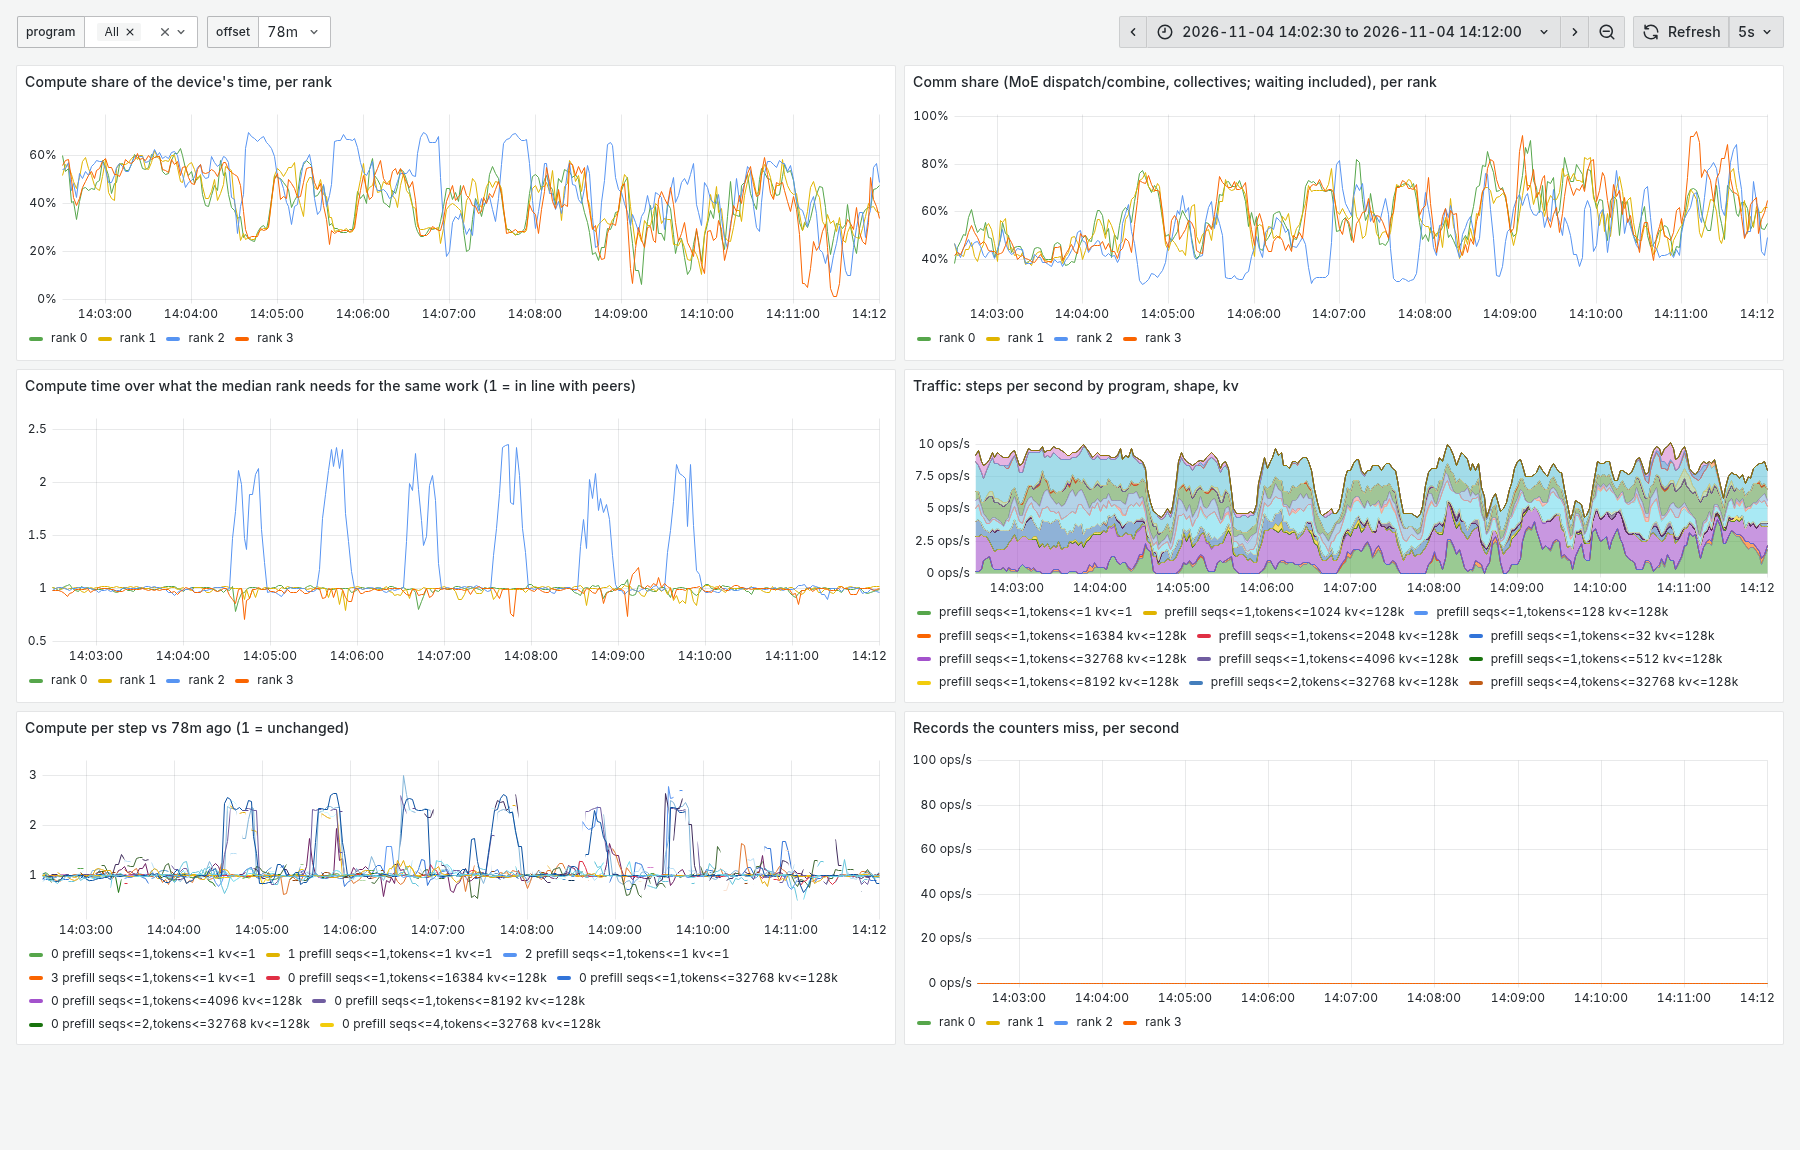
在第一行:你几乎可以一眼看到,rank 2 的 compute 时间,有一个明显的峰,同时其他卡的通信增加(因为需要等 rank 2)。
第二行则更加明显,其他 rank 都非常稳定,rank 2 这个尖刺非常明显。
这样 SRE 几乎可以瞬间知道问题在哪个卡,大概率是什么问题,rank 2 的 GPU 跑计算有点问题。
给 kernel 工程师
下面主要围绕 prefill 负载展开。
第一个使用案例比如,线上跑了一天的流量,想要给之后的优化做一些分析,看看时间花在哪里了:
create table share as
with c as (
  select rank, seq, dur_ns,
         case when call like 'prefill.target.moe.layers.%.experts' then 'MoE'
              when call like 'prefill.target.attention.layers.%.attention' then 'attention'
              when call like 'prefill.target.attention.%' then 'attention projections'
              when call like 'prefill.index%' then 'indexer'
              when call like '%mhc%' or op like 'dsv41_hc%' then 'mHC'
              else 'other' end as what,
         case when call like 'prefill.target.moe.layers.%.experts'
              then dur_ns - min(dur_ns) over (partition by seq, call) else 0 end as wait_ns
  from k)
select rank, seq, what, sum(dur_ns - wait_ns) as ns from c group by all
union all
select rank, seq, 'waiting in MoE', sum(wait_ns) from c where what = 'MoE' group by all;

-- the whole run, each rank from its first step to its last
select what, sum(ns) / sum(sum(ns)) over () * 100 as pct
from (select what, ns from share
      union all
      select 'between steps', max(end_ns) - min(start_ns) - sum(end_ns - start_ns) from s where program = 'prefill' group by rank)
group by what order by pct desc;

-- full 32k-token steps of one sequence, by how long that sequence's context is
select case when kv < 65536 then 'up to 64k' when kv < 131072 then '64k to 128k'
            when kv < 262144 then '128k to 256k' else '256k and more' end as context,
       what, count(*) as steps, avg(ns) / 1e6 as ms
from share join s using (rank, seq)
where s.vars = 'seqs=1,tokens=32768'
group by all;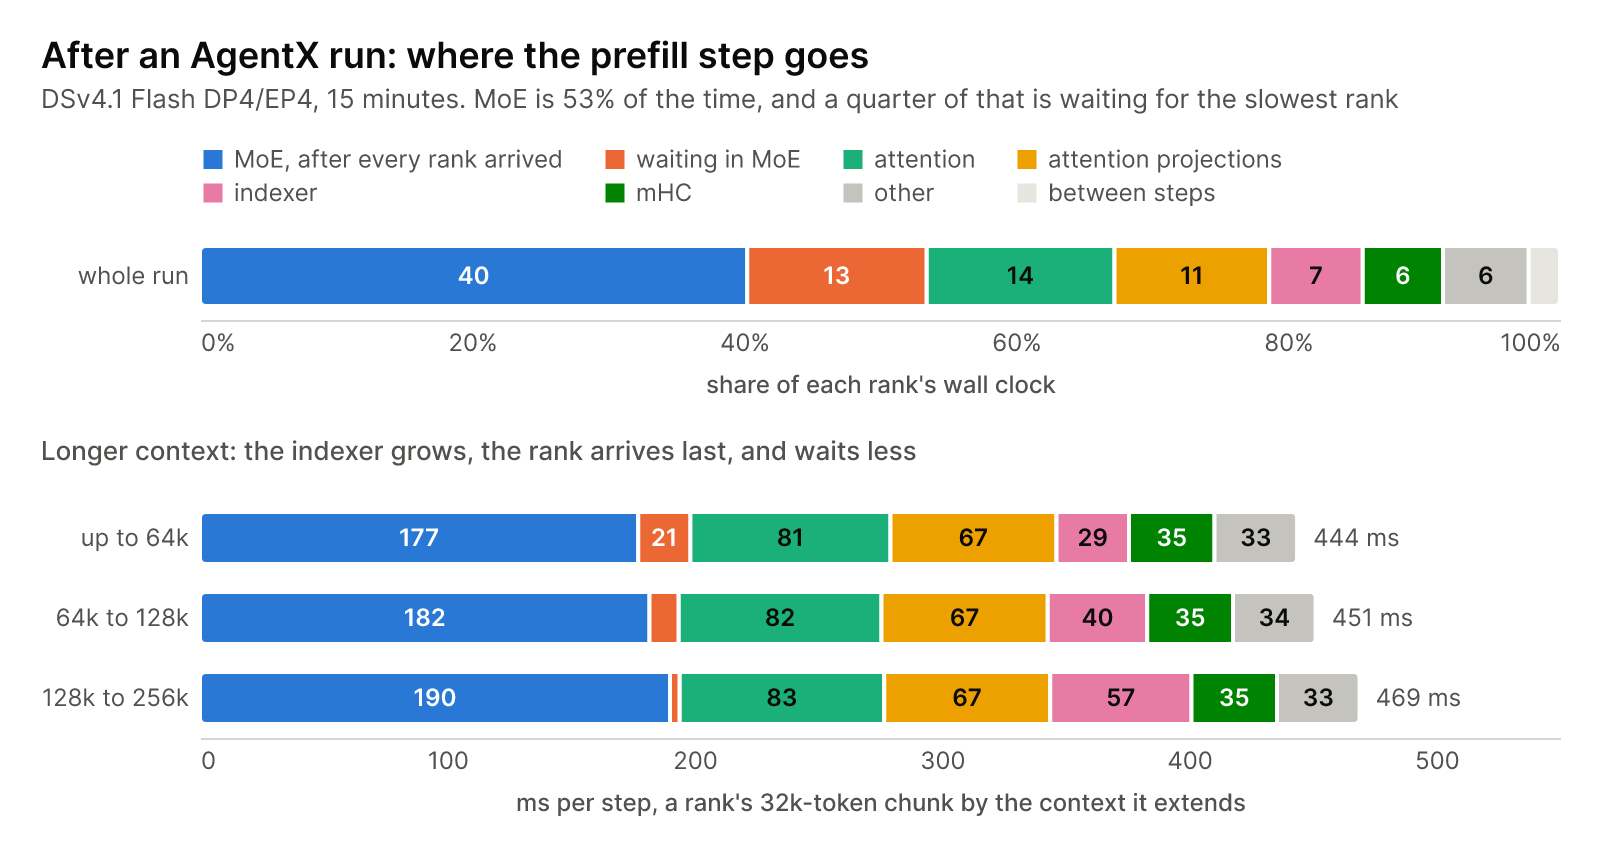
不仅可以直接看全部 kernel 耗时,甚至能看 prefill DPLB 的问题。
这个 DPLB 是怎么算的呢?因为 4 个 rank 都要进入 MoE all to all 才算开始,总耗时 - 最慢到达的 rank 耗时即可,就是 DPLB 带来的“损耗”。比如这里就损耗了接近 13%,这也是我认为前不久 DeepSeek 报告花大量技术在解决的问题,包括做了一个 prefill 代价估计器是吧。
我们也可以细粒度观察 MegaMoE,虽然大家因为 DPLB 的问题,到达时间各不相同,但是结束时间都差不多,所以我们可以用最晚到达的 rank 的 kernel 时间,估计 MoE 实际所花的时间:
with m as (
  select seq, regexp_extract(call, 'layers\.([0-9]+)', 1)::int as layer,
         min(dur_ns) as after_all_arrived, max(start_ns) - min(start_ns) as wait
  from k semi join full_steps using (seq)
  where op like '%mega_moe%' and call like 'prefill.target.moe.layers.%'
  group by seq, call having count(*) = 4)
select layer, quantile_cont(after_all_arrived, 0.1) as p10, median(after_all_arrived) as p50,
       quantile_cont(after_all_arrived, 0.9) as p90, median(wait) as wait_p50
from m group by layer order by layer;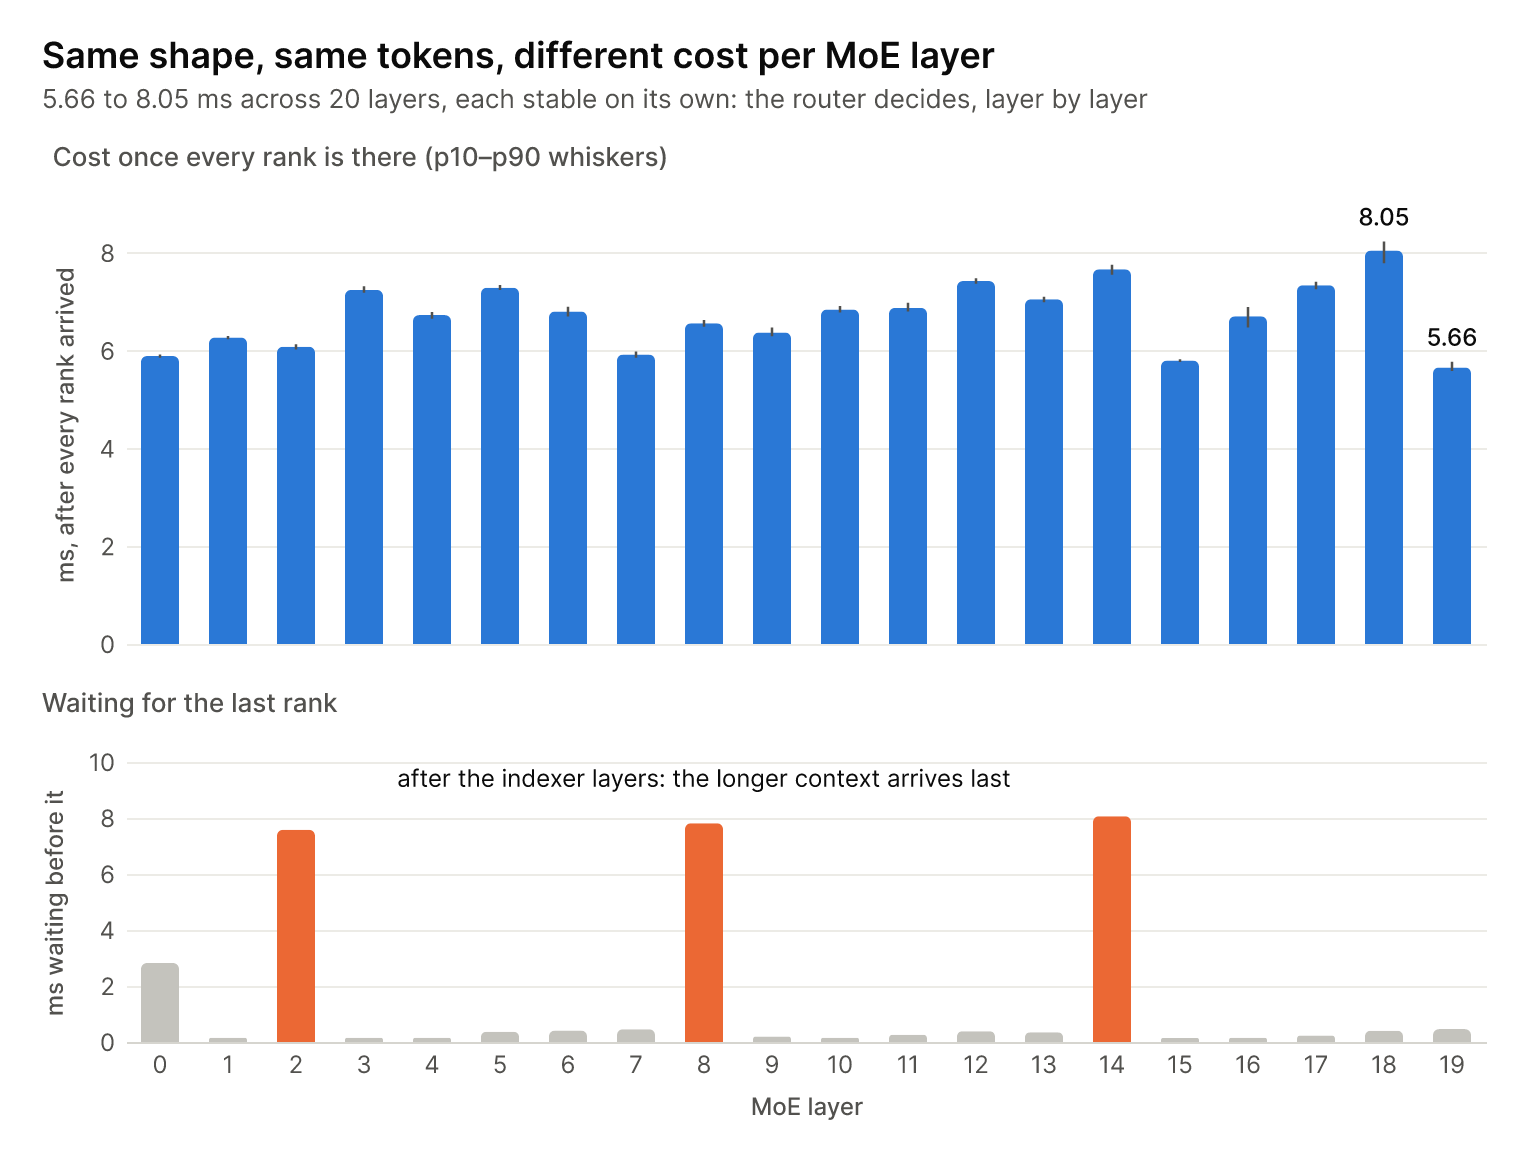
上半部分,对比的是相同形状的计算,每一层有自己的激活,可以看 EPLB,还是有一些问题的,在 5.66 ms–8.05 ms。
下半部分,看的是 MoE 到达时间问题,2、8、14 前面有个 indexer,各个 rank 的上下文长度不同,indexer 计算量不同。
虽然本文不探讨 DPLB,但假想开发人员做了 DPLB 的优化,也可以上线跑一天,得到 48 个 Parquet,重新运行一个 SQL 就可以得出 DPLB 的优化程度,这也太 amazing 了。
当然还有很多分析,可以去探索,特别是这个 feature 可以和 inference RSI 结合起来。
常开的开销
在 HES 之前,大家用各种技术做这个 kernel 信息观测,开销是第一个大问题。那么 HES 作为硬件 level 的 feat,开销到底如何呢?
首先 HES 确实相比不开,有全面的性能提升,graph 内每个节点的开销从 0.8 μs → 0.6 μs,同时带来更干净的 P99(观测自身造成的 P99 好很多),1344 ns → 704 ns。
我们还是直接看接入引擎后对 E2E 性能的影响吧。
我们先用 GB300 推理一个 Qwen3-4B,也就是大炮打蚊子,每个 kernel 都很快,让 HES 的开销放大出来。
负载是 random 数据集,输入 1024 ± 25%,输出 256。
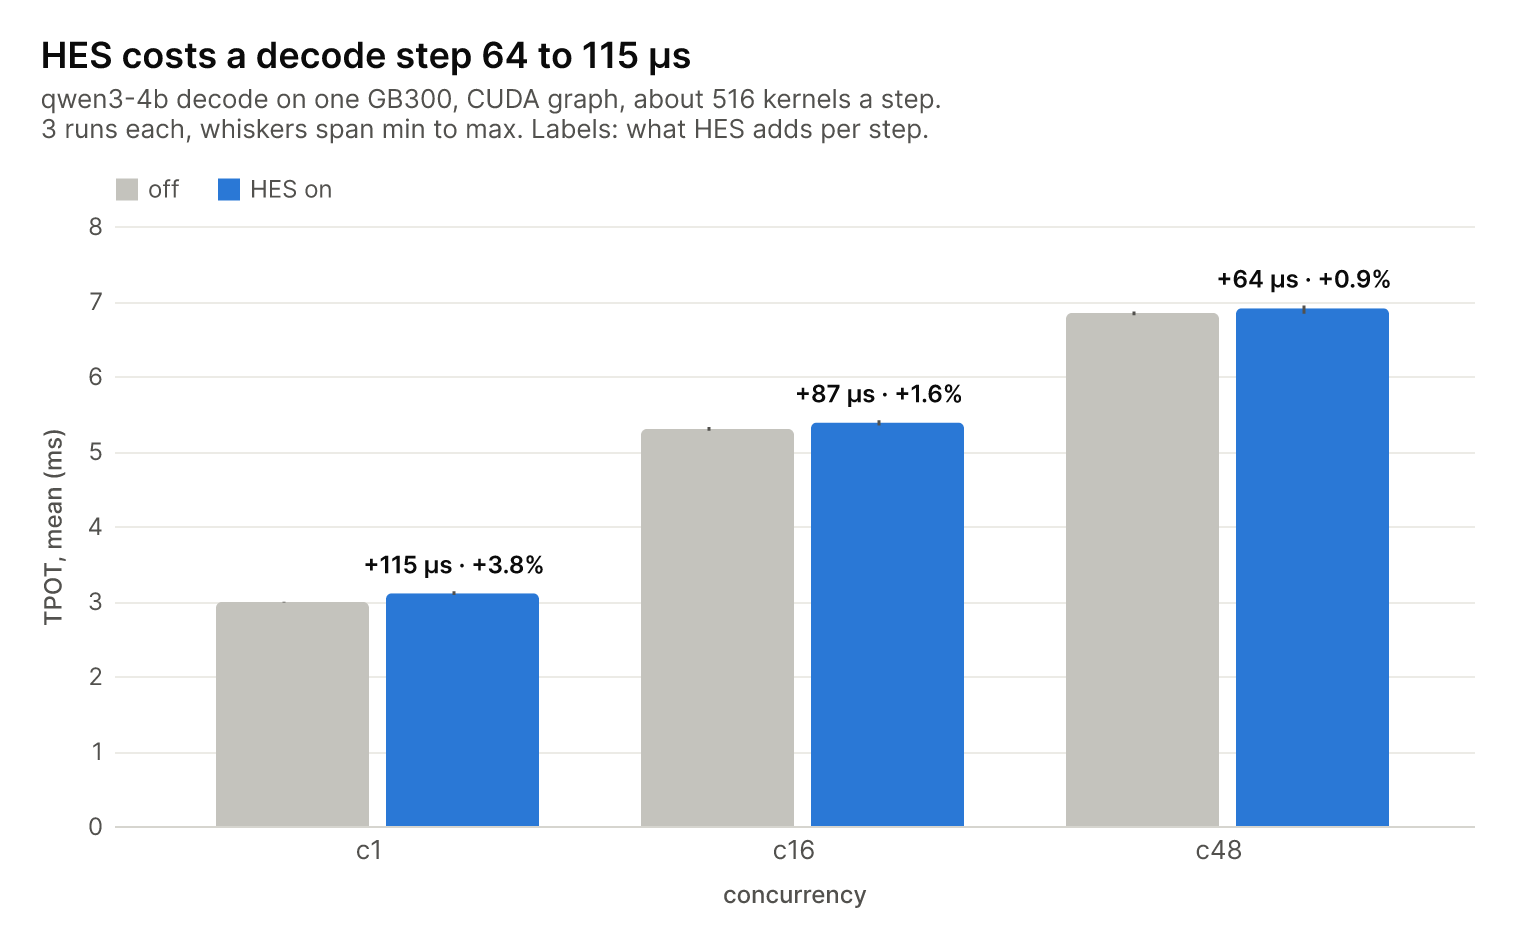
c1 的时候开销增加 115us(每个 decode step),到 c48,只增加 64 μs 的时间,也就是 <1%。
v4.1 Flash + Agent workload 下,也没有体感出差异。
| 轮次 | 请求数 | TTFT 均值 | TTFT p50 | 输入吞吐 |
|---|---|---|---|---|
| off-r1(不开 CUPTI) | 1042 | 263.7 ms | 93.3 ms | 321.6k tok/s |
on-r1(--trace) | 1043 | 252.3 ms | 96.5 ms | 322.3k tok/s |
接入 Kern
首先你可能要明白 kern 的设计哲学(抱歉,一直没写 kern 自身的 blog),简而言之,kern 并不感知“模型”是什么,它只知道静态图,先 kernel A,然后 kernel B,完全不感知 kernel 是干嘛的。这静态图就是 manifest,manifest 里每个 program(prefill、decode)是一串 call,每个 call 有一个 label(比如 prefill.target.moe.layers.8.experts)和一个 op。Kern runtime 执行 program 有两种方式(每个 program 自己注明是否需要 graph):
- eager:按顺序一个个 launch;
- graph:先在一条 stream 上 capture 成 CUDA graph,之后每步 cuGraphLaunch 一次。
但是如果按之前那样采集,采集出来的 kernel 名字大概率是编译后的符号名,不太好读。但 kern 生成这个 manifest 的时候是可以写名字的,也就是用户自己指定的名字,比如映射这个 DeepGEMM、MegaMoE xxx → MoE group GEMM。
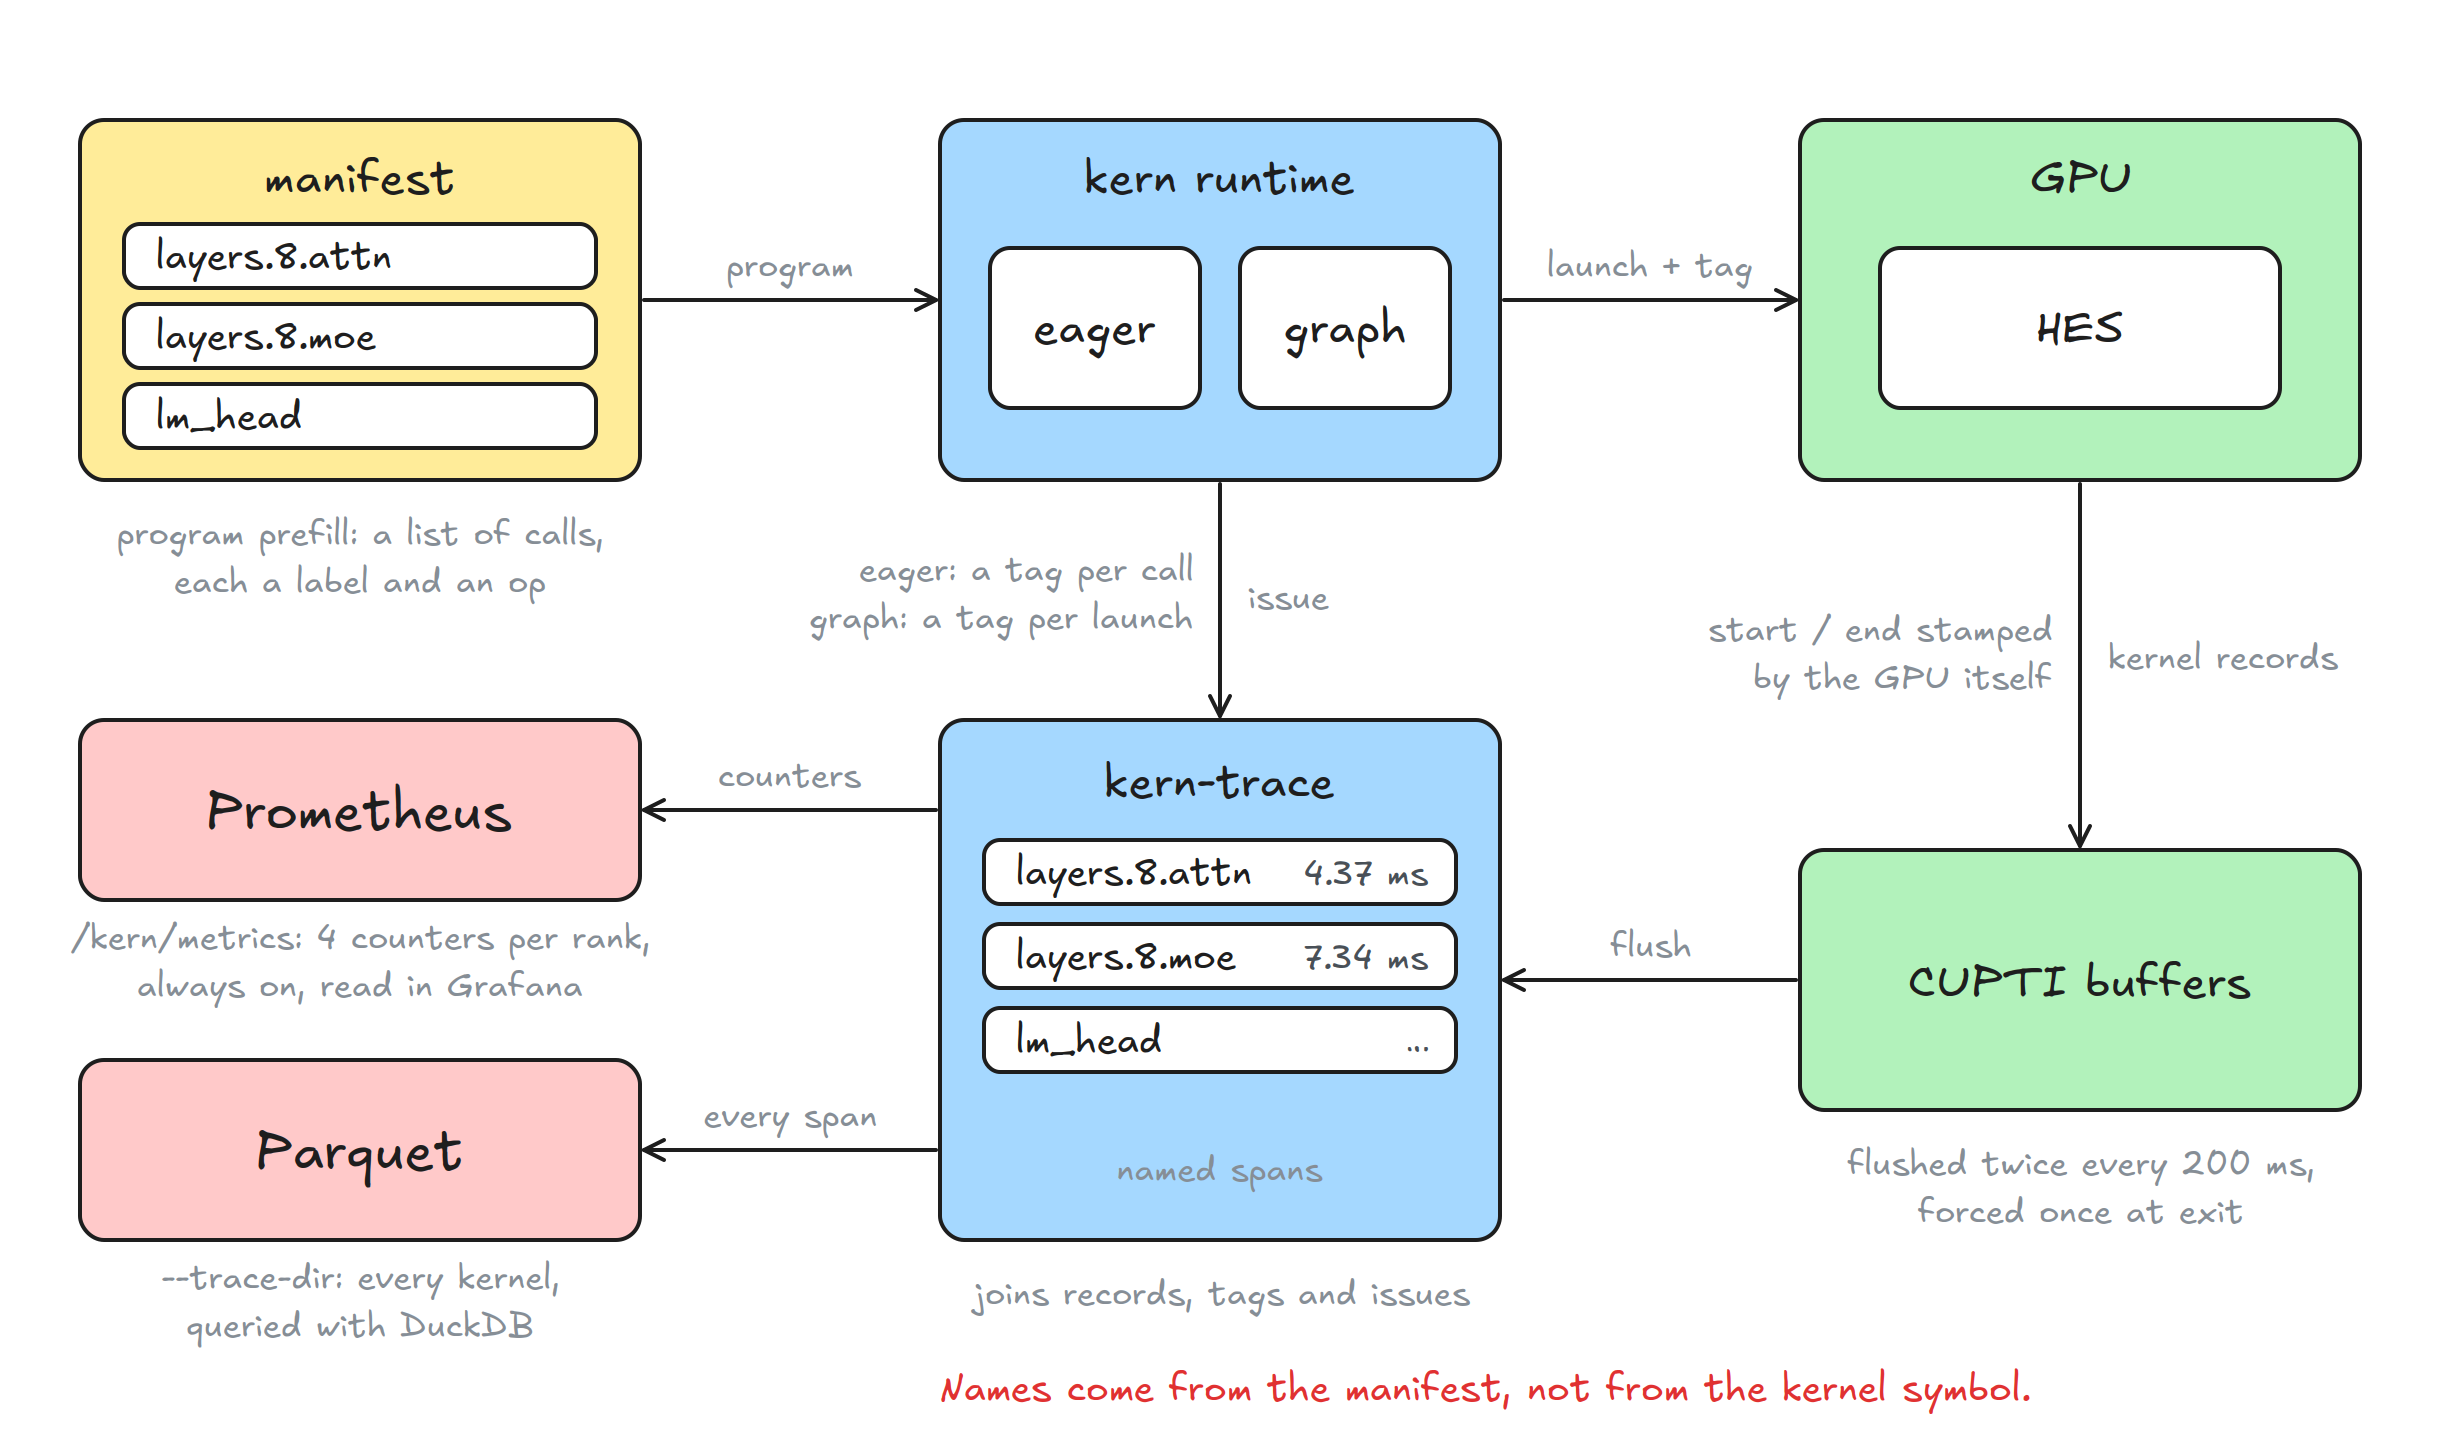
剩下其实就是一些 CPU 整理的工作,异步化主要是,然后更新相应的 counters,包括在内存开始写 Parquet,每 30 分钟落盘。
不稳定提醒
比如我们看 CUDA 13.4 和 HES 的一些更新公告吧:
Fixed a host heap corruption issue that could occur when using CUPTI HES trace (
cuptiActivityEnableHWTrace).Fixed CUPTI HES activity so that
graphNodeIdfield retains the fullgraphId(upper 32-bits) in CUDA-graph memory copy records.Fixed a race condition in CUPTI HES mode that caused intermittent crashes during
cudaGraphInstantiate…Fixed a memory leak when HES is enabled that caused approximately 100 bytes of host memory to leak per kernel activity record.
Fixed a system crash and intermittent zero-valued timestamps in HES mode during concurrent context destruction.
有堆损坏,有崩溃,有内存泄漏。
也许之后的版本能逐步稳定呢,是吧。期待!
不过我这几天 CUDA 13.3 跑下来,没有遇到太多问题。
参考资料
- CUPTI 13.4.1 Usage §2.3.6 Hardware Event System (HES) —— 唯一一段把 HES 讲清楚的正经文档:Blackwell 新硬件方法、opt-in、依赖 Perfworks、全部限制(MPS/MIG/SLI/CMP/机密计算不支持;不能晚 attach;开了不能关;和 latency timestamp 不兼容;固定 128 MB buffer 且不自动 flush,满了丢记录;部分字段拿不到)。同页 §2.2.1 说明
CUPTI_ACTIVITY_ATTR_ENABLE_HES必须在 subscribe 之前用 v2 API 设置。 - CUPTI 13.4.1 Usage §2.3.7 CUDA Graphs —— 明确“For performance reasons, HES is recommended for node-level tracing”,以及 device graph 的 per-node 记录只能走 HES。
- CUPTI 13.4.1 Usage §2.17 CUPTI overhead —— 传统 tracing 的开销来源(callback、buffer flush、零初始化等),对比 HES 时的基线。
- CUPTI Activity API 参考 ——
cuptiActivityEnableHWTrace、cuptiActivityFlushPeriod、属性枚举的正式签名与错误码。 - CUPTI Release Notes —— 按版本查 HES/时间戳相关改动。