K3.1 Pro RSI
https://github.com/pegainfer-project/kern-k31
WIP: 将 kern 优化好的 kernel 直接在 你的 vllm/sglang 中使用,pip install 即可,我们会自动 plugin 到 forward 上。k3 已经支持,k3.1 主要看这两引擎怎么写的代码。
我们 day0 的是个 repo,kern 主体并不需要改什么,kern-k31 就放 k31 相关的 kernel,并行策略这些。然后整体优化还是用的 kern 的这套 harness。
昨晚上发的,简单支持了个 day0(给了他 vllm sglang的 pr),然后挂了一个 loop,跑了大概一整天,他自己说没啥能干的了。
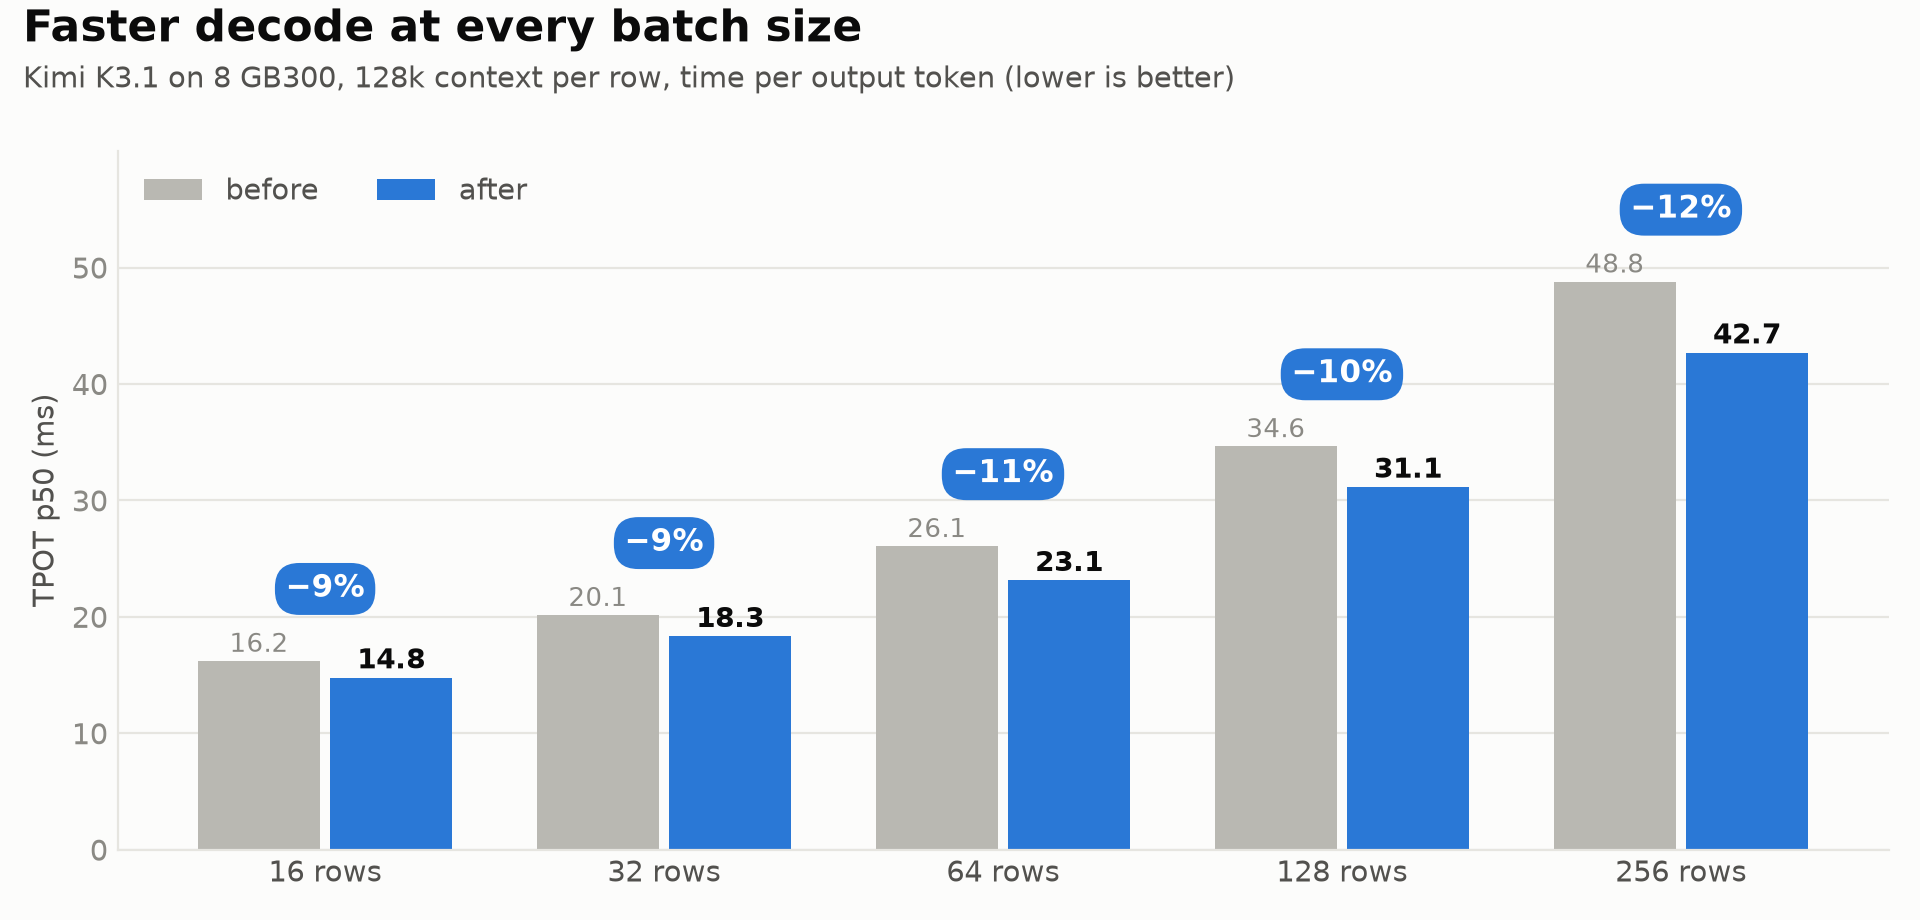
优化的目标是K3.1 的 decode 共 8 卡,TP8,无投机解码。每个请求的上下文是 128k。分数是 16、32、64、128、256 行五档 TPOT 中位数的加权平均,权重依次是 1、2、4、4、2,线上批大小最常落在 64 和 128 行,所以这两档权重最高。
优化的 Loop 呢,大体就是我挂一个 claude code 的,prompt 类似这样,/loop 20m 优化 K3.1 Pro 的 deocde 性能,尽量用 sub agent优化,你只负责编排他们,以及决定最后是否合入,xxx。
每个优化一个 commit,
- bit 相等的,直接走 kern bench 看分数
- 不相等的,走 kern test 看精度是否合理,过了才能走 kern bench 打分
bench 的输入是真实文本,随机 token 会让路由挤到少数专家上,64 行一步少算约 3 ms,分数虚低
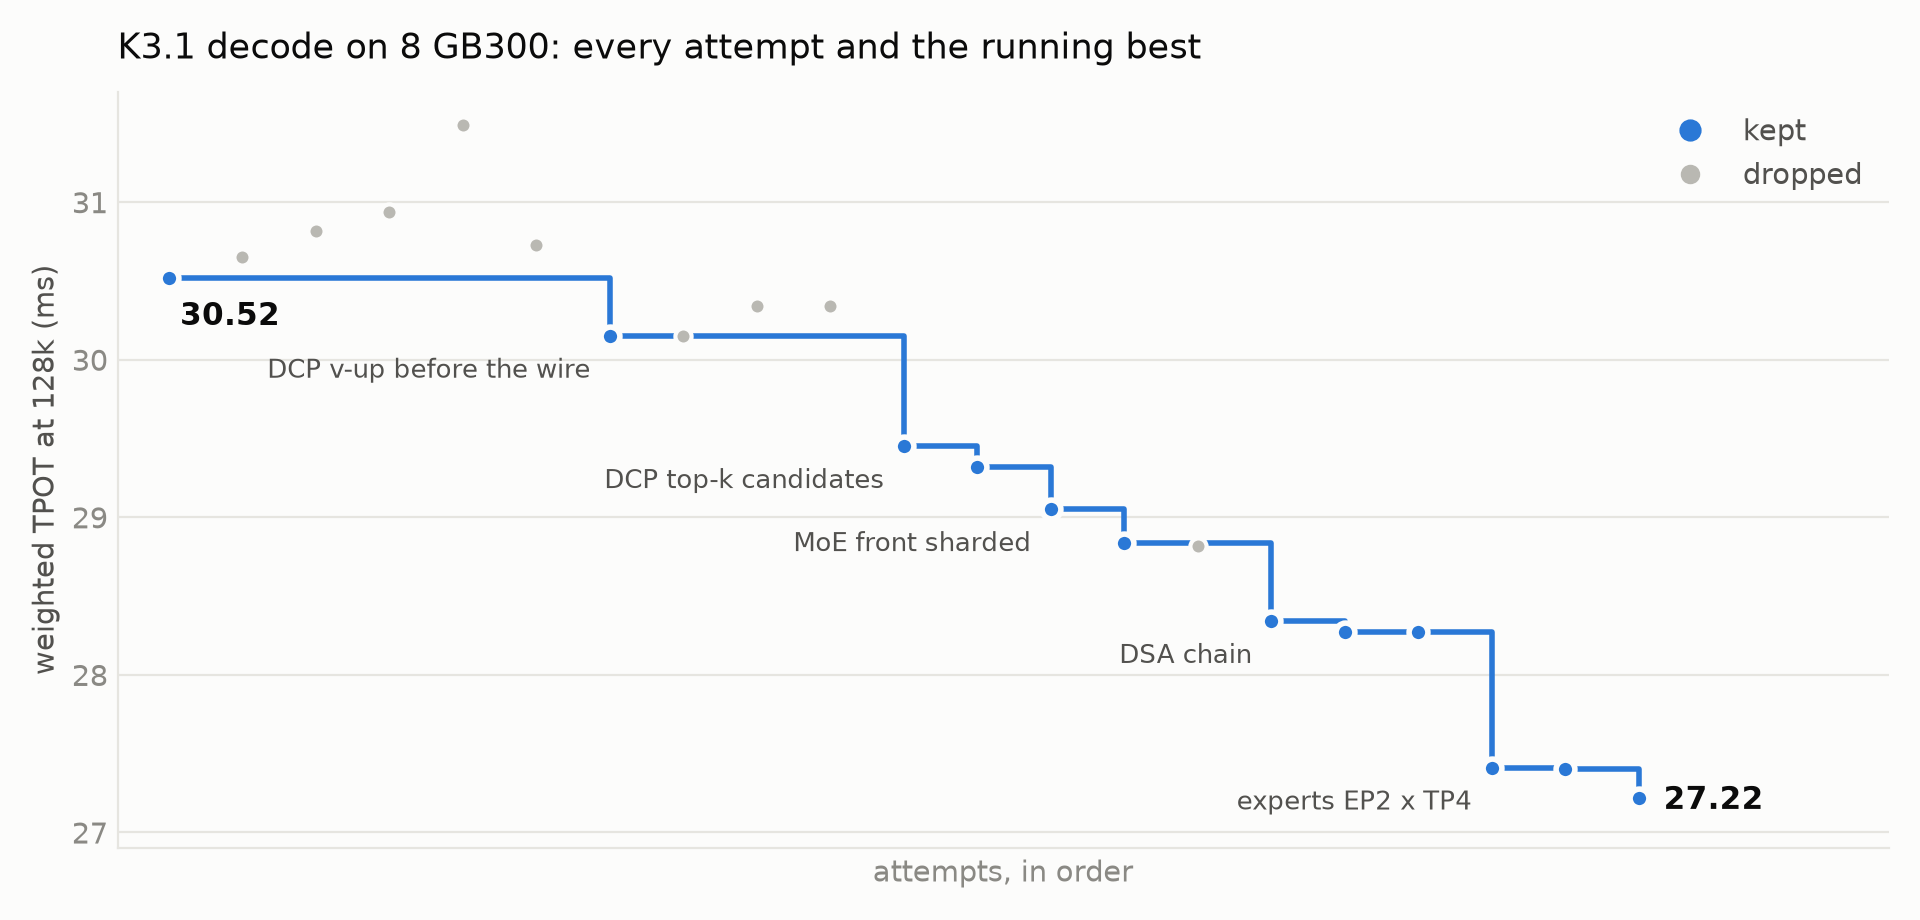
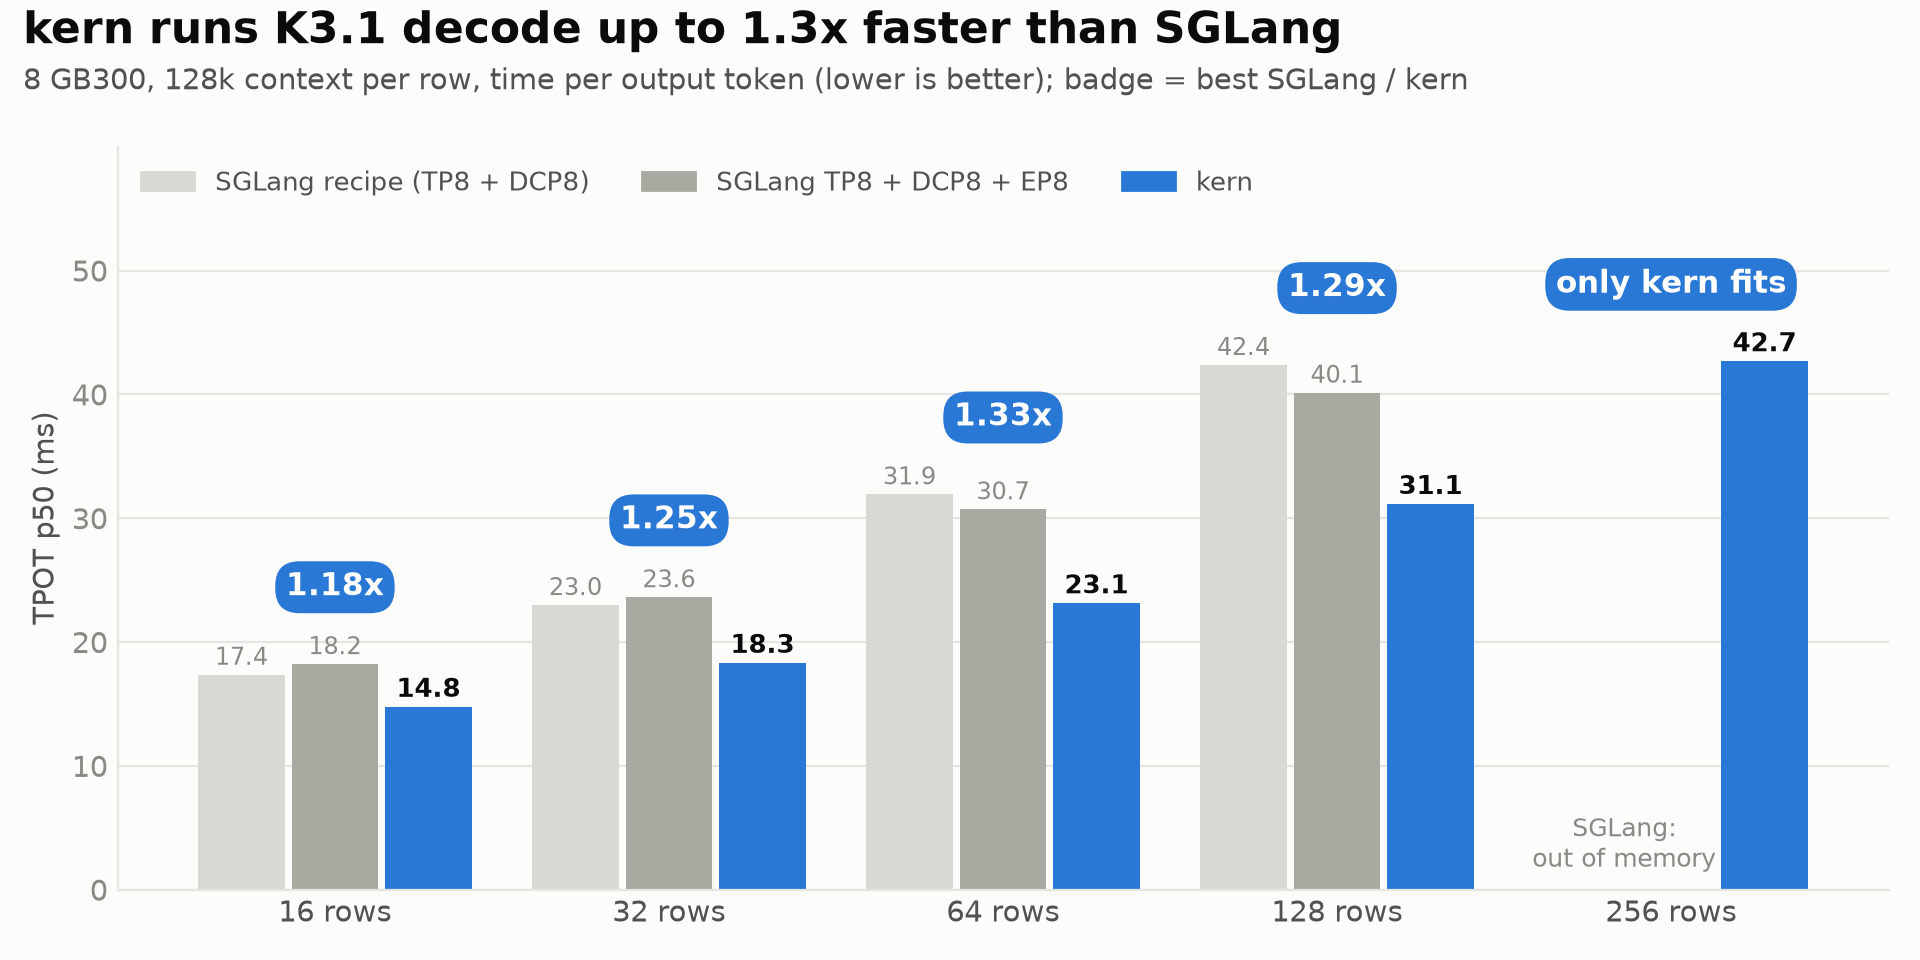
分数从 30.52 ms 降到 27.20 ms,快了 10%,每一档都变快。同样 8 卡、每个请求128k,比 SGLang 的官方配方最多快 1.3 倍;BS=256 时 SGLang 显存放不下。
单项收益最大的是把专家执行改成 EP2×TP4,省 0.86 ms,省下的是各 rank 等最慢那个 rank 的时间。其余合入的改动每项省 0.1 到 0.7 ms,集中在 DCP 的 top-k、DSA 链路和 MoE front 三处。
所以 Kern 是 Attn TP8 + CP8, MoE 部分是 EP2 + TP4.
继续抠单个 kernel 的空间已经不大。128 行的一步里,MoE 专家 GEMM 占一半以上,它读专家权重的速度已经到 HBM 带宽;剩下的每一项都只有 0.1 到 0.5 ms。
具体的优化旅程
分数变化是对当时 main 的差值,负数表示变快。
阶段一:只有 16、32、64 行三档(分数和后面不可比)
| # | 尝试 | 分数变化(ms) | 结果 |
|---|---|---|---|
| 1 | bench 输入从随机 token 换成真实文本 | 20.69 → 23.37 | 采纳。之前的分数偏低 |
| 2 | KDA core 按 PDL 启动 | +0.05 | 合入,噪声内 |
| 3 | MLA 链按 PDL 启动 | −0.08 | 合入 |
| 4 | KDA core 的 block 常驻 | −0.06 | 合入 |
| 5 | top-k 只建一次直方图 | −0.34 | 合入 |
| 6 | 支持 128 和 256 行 | — | 合入。分数改成五档,起点 30.52 |
阶段二:五档分数
| # | 尝试 | 分数变化(ms) | 结果 |
|---|---|---|---|
| 7 | cuBLAS 固定算法 | — | 放弃。默认启发式已经是候选里最快的 |
| 8 | MoE FC1、FC2 换 kernel 变体(12 个) | 0 到 +7.9 | 放弃。没有一个比默认快 |
| 9 | moe_front 改成一条 TMA 链 | +0.21 | 放弃。单测快 20%,放进整步反而慢 |
| 10 | 自写 dense GEMM | 估算 −0.4 | 没做。收益抵不上维护成本 |
| 11 | DCP 的 v-up 挪到通信之前 | −0.37 | 合入。求和顺序变,过门 |
| 12 | 静态 EPLB | 估算最忙 rank 的 MoE 负载 −10% | 没做。不采用离线固定的专家放置 |
| 13 | DCP top-k 候选:压成一个 32 位字、调度只做一次、先发 load、12 位基数 | −0.72 | 合入 |
| 14 | absorb 挪到 pack 和 select 之间 | 0.00 | 放弃 |
| 15 | shared expert 的 down 在 96 行以上挪到 FC2 之后 | −0.13 | 合入 |
| 16 | shared down 用自写的尾 kernel | +0.19 | 放弃。输给 cuBLAS |
| 17 | moe_front 每个 SM 放两个 block | +0.19 | 放弃 |
| 18 | lat_down 按 8 路切分,在 moe_front 里收齐 | −0.27 | 合入 |
| 19 | all-reduce 只重置自己上次写过的位置 | −0.21 | 合入 |
| 20 | all-reduce 成对 epilogue | −0.02 | 放弃。只有 256 行受益,要加约 120 行代码且有寄存器溢出 |
| 21 | all-reduce 收齐之后再重置 | 单测变慢 | 放弃 |
| 22 | all-reduce 的 epilogue 只在 owner rank 做 | — | 放弃。gather 已经用满链路 |
| 23 | o_proj 的 epilogue 直接写进 all-reduce | — | 放弃。cuBLAS 会写出 −0.0,和“数据未到”的标记冲突 |
| 24 | KDA core 换四种线程映射 | 全部更慢 | 放弃 |
| 25 | DSA 链:hot-384 候选合并、idx_kw 并进 wfu、absorb 从 65 行起用 tcgen05、idx_key 并进 mla_prep | −0.50 | 合入。其中一项改了求和顺序,过门 |
| 26 | pack 和 select 合成一次 launch | 0.00 | 放弃 |
| 27 | lat_up 每卡只存 1/8 的列,最后 gather | −0.09 | 合入。每卡省 4.1 GB 权重 |
| 28 | sparse MLA 不再按 PDL 启动 | 0.00 | 合入。它在 wait 之前读了上游的输出,lanes 会让这个竞争暴露出来 |
| 29 | PDL 审计,删掉 ar_finalize 里没用到的 early 分支 | 0.00 | 合入。wait 之前的 55 处读取都查过 |
| 30 | 专家改成 EP2×TP4 | −0.86 | 合入。求和顺序变,过门 |
| 31 | lanes:q_b 和 absorb 放到第二条流,和 indexer 并行 | −0.18 | 等 kern#112 合入 |
| 32 | front 的 f32 GEMM 去掉 split-K reduce | — | 放弃。自写 kernel 在 32 行以上更慢 |
128 行一步里还剩什么(rank 0,ms)
| 部分 | 时间 |
|---|---|
| MoE FC1 + FC2 | 17.2 |
| dense cuBLAS 投影 | 8.5 |
| ar_finalize(MoE 跨 rank 求和) | 1.9 |
| attention 侧 all-reduce | 1.7 |
| KDA core | 1.7 |
| indexer logits | 1.4 |
| moe_front | 1.2 |
和 SGLang 的对照怎么比的
SGLang 用 K3.1 的官方镜像跑了两种配置:官方配方 TP8 + DCP8(MoE 走 TP8),以及再加 EP8。权重、fp8 KV、每行 128k、decode 走 CUDA graph 这几点和 kern 一致,两边都不开投机解码。官方配方的 KDA 状态是 fp32,EP8 配置改成了和 kern 一样的 bf16,profile 里两者的 KDA 耗时相同。SGLang 的 TPOT 取服务端 decode 日志里批大小恰好等于目标值的区间,取中位数。