vera rubin 初探
可能 NV 在搞宣发了,今天 vllm sgl 同时发 vera rubin
https://vllm.ai/blog/2026-10-09-vera-rubin-preview
vllm 这个图画的很棒啊!点赞,侵权可删。
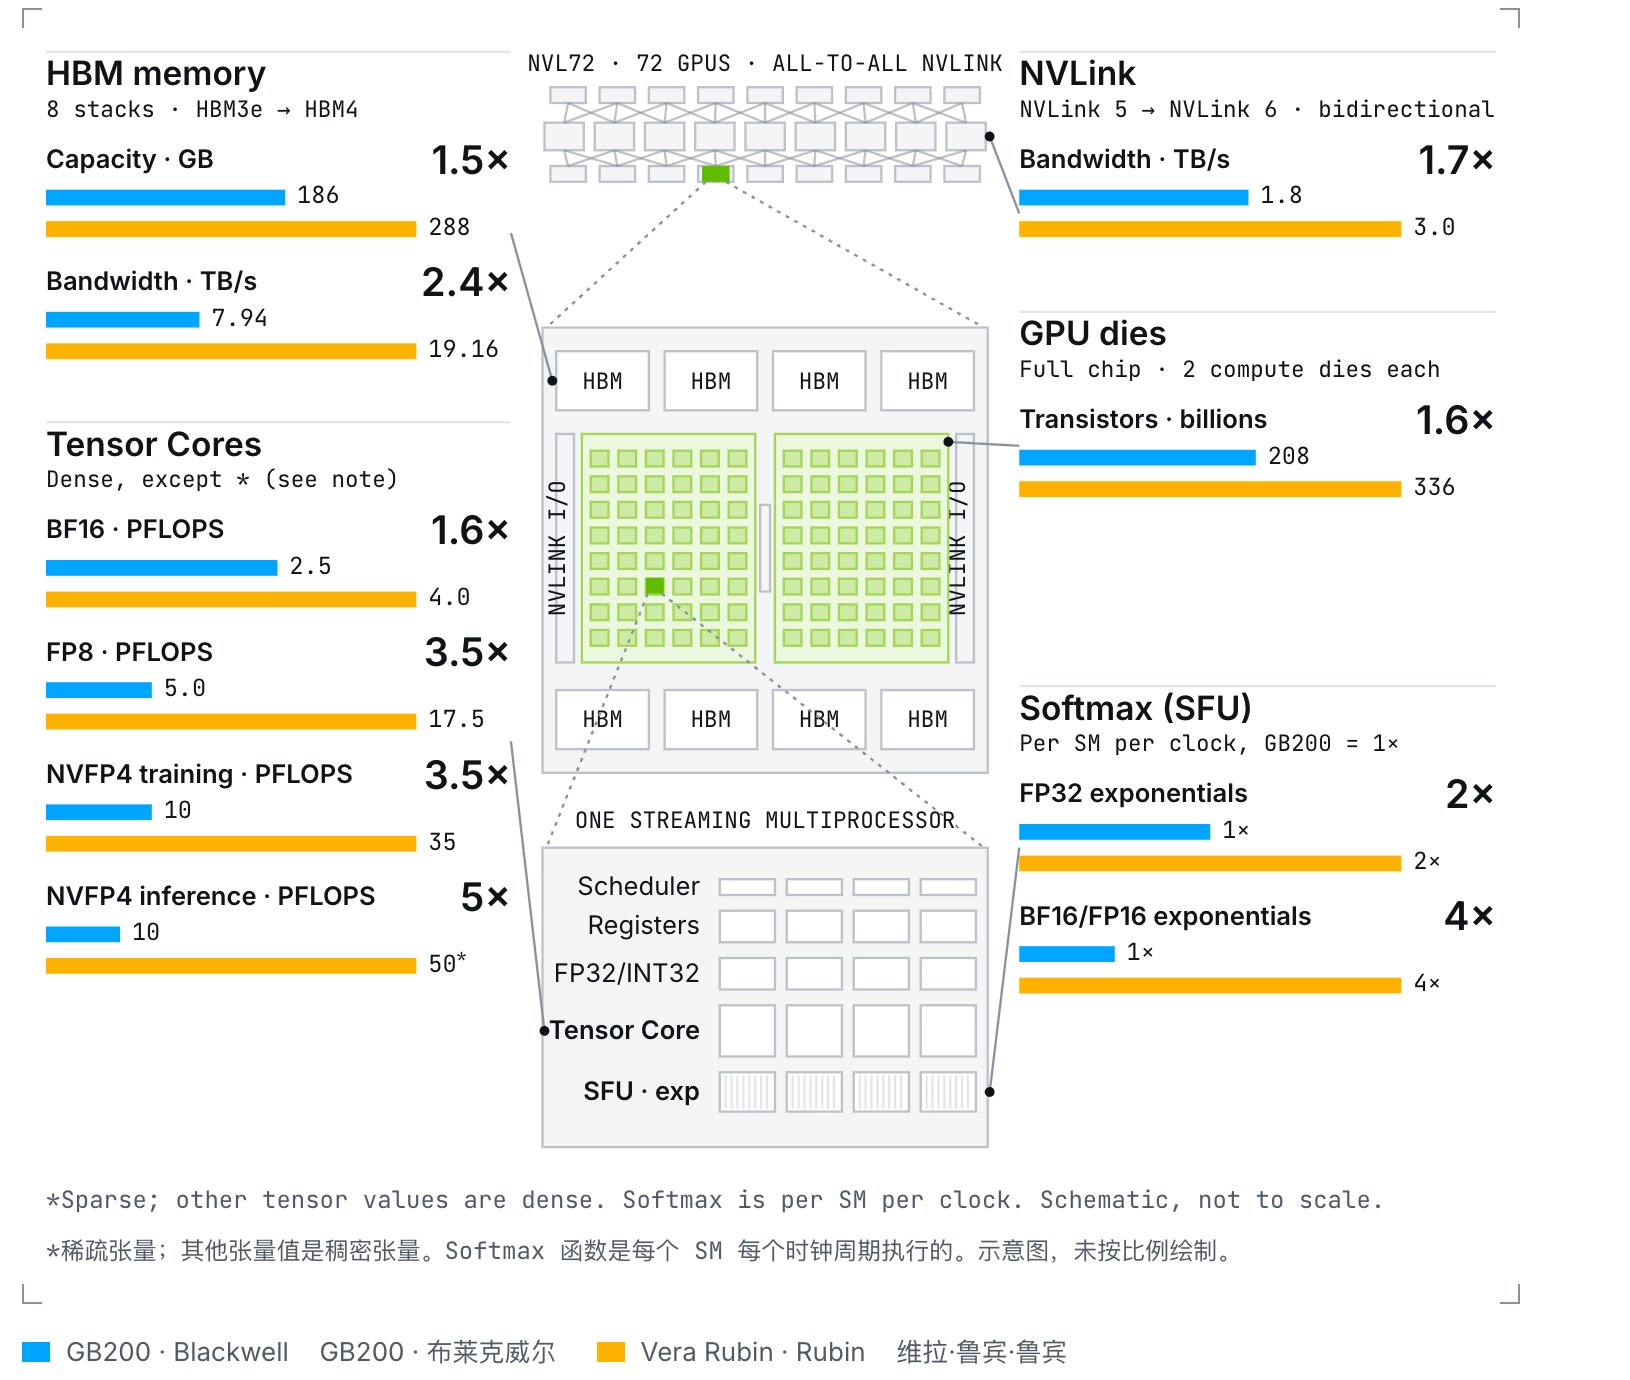
其实这里我是想聊一些深刻的东西的,比如容量带宽比,比如 GB200 读一遍自己的显存需要 23.4ms,而 verda 只需要 15ms。包括 NVLink 带宽的进一步上涨,但依旧需要算比例,GB时代,NVlink 可以达到显存带宽的 22%,Vera 时代只有 15.7%。但是总的来说 3 TB/s,也给了更多想象空间。
somehow,总之从这里看,vera 只是一个更好的 BlackWell.
重要的是后面的 The Vera Rubin Platform
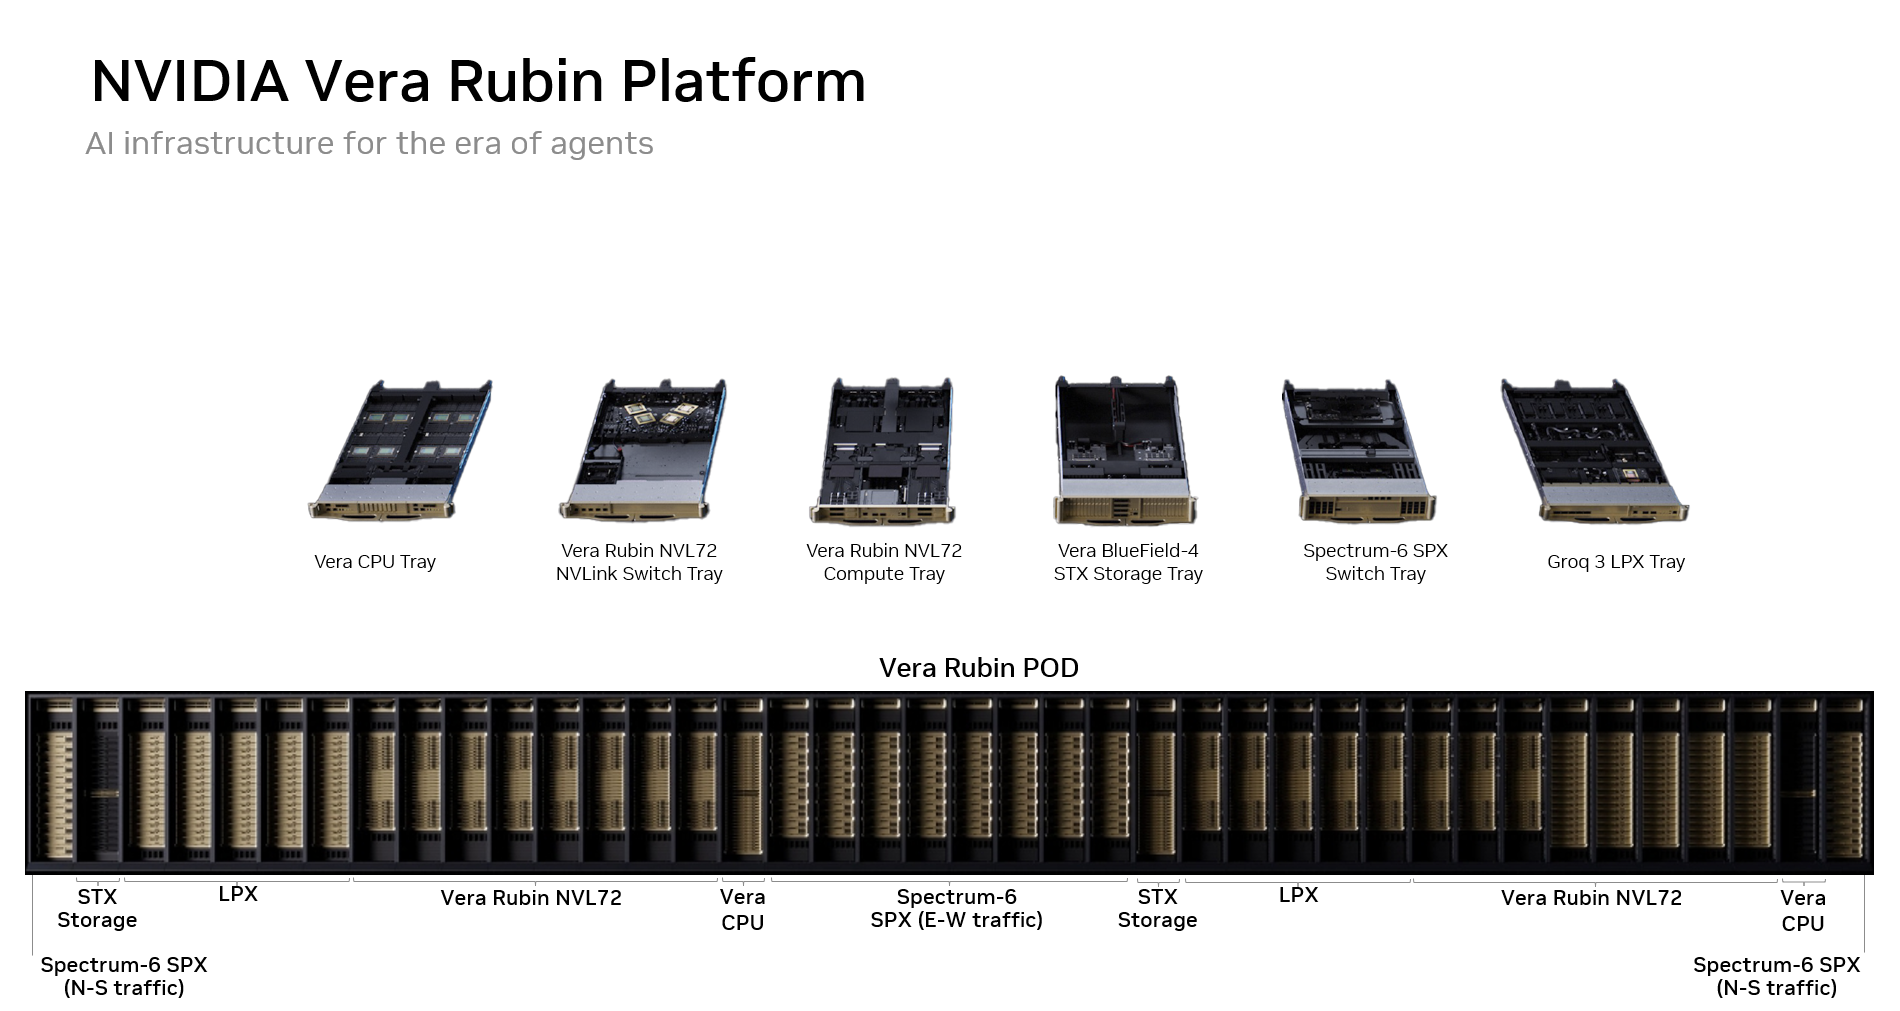
最有意思的就是这个 Groq3 LPX Tray 了,它不和 Vera Rubin GPU 在一起,在一个单独的 Tray 里,不知道怎么通信的。
来看看vllm 做的 feat 吧,好像vllm 也没摸到 lpx,看起来没啥人摸到 lpx,而且 NV 自己好像也不怎么提。
就是 GPU 的 NUMA,cuda 13.4 支持了局部性(https://docs.nvidia.com/cuda/cuda-programming-guide/04-special-topics/locality-domains.html) ,有点类似 CPU OLAP 的 numa aware schedule。
举的例子是 MoE decode,bound 在读权重,所以走 numa aware 实现更好的吞吐,权重放置的时候就 aware 好。
再看看 sglang 的,https://www.lmsys.org/blog/2026-10-09-vera-rubin
大部分都是常规优化吧,没有看到啥特别”Vera Rubin”的。
不过推理是这样的啊,依赖基模公司的 trainning,对模型结构没有话语权。国外 vera 都还没完全铺开吧,国内用 vera 训估计在 至少明年年底吧,开源出来的新架构给到推理侧,可能是后年了。
还是回去读 NV 的吧,https://developer.nvidia.com/blog/inside-nvidia-rubin-gpu-architecture-powering-the-era-of-agentic-ai/
题外话,感觉看 13.4 的一大感觉是,NV 在增强,切单个 GPU 干多个活的能力,或者说增加 GPU 调度 sub task 的能力,越来越 OLAP 化了哈哈,MPS, GC 都有一些加强,因为 Vera 来到了 224 个 SM。
一些这个指令的改进,针对 group gemm 定制“指令”?somehow 有一些新指令干 group gemm 吧。
哦,然后是 tp 的改进,因为之前 hopper, blackwell 都需要比较合理的k 维度,现在 rubin 加强了一下硬件的这个能力,改善了一下 k 维度,利好 tp。
然后是 attn 这边的改进,针对这个topk 系的稀疏的改进,比如 4 出 top2,选出两个值 → 压缩并生成位置 metadata → 后面直接用 2:4 sparse MMA 算。然后也是 softmax 的硬件 level 改善吧。这里的点可能在于,利好 topk 系列吧,没理解错吧?
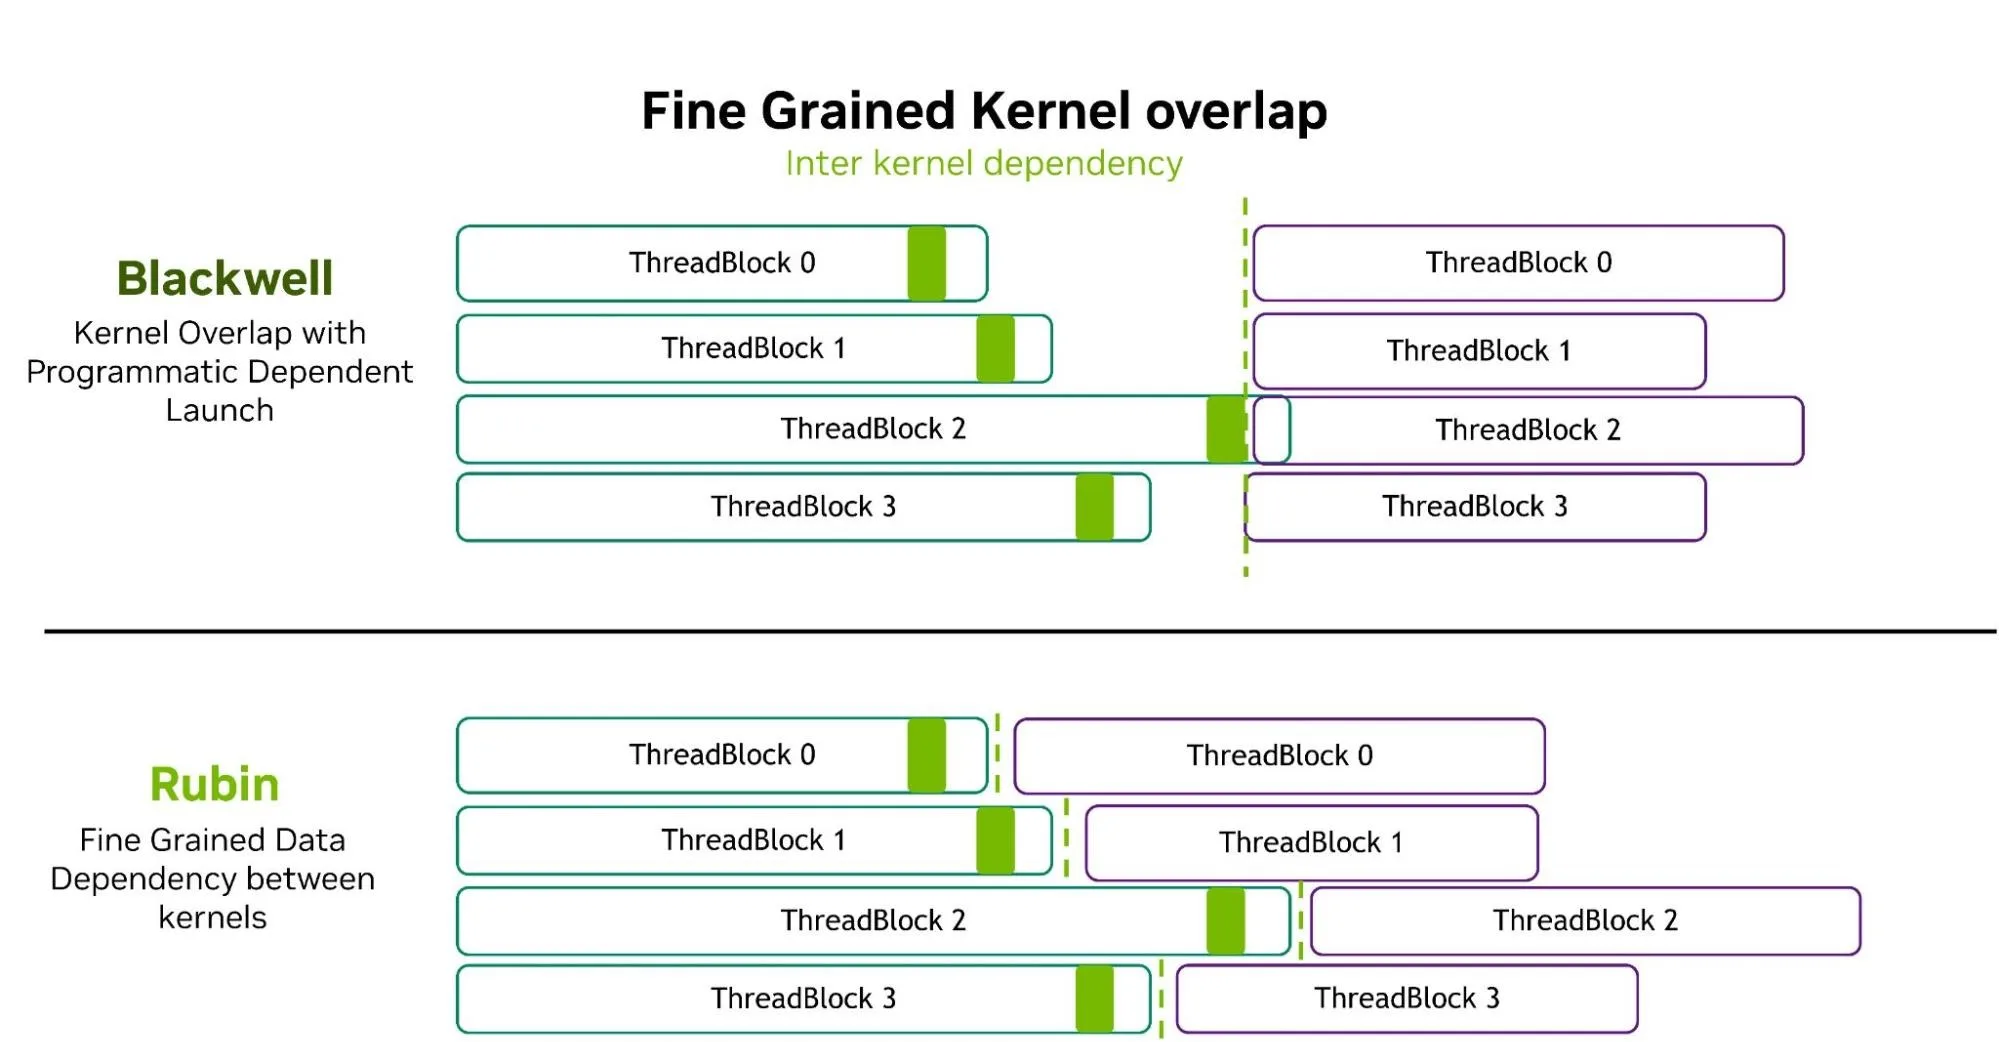
Rubin 可以实现更加细粒度的算子之间的协作,不知道具体的 API。
NVLink 增加了一个新的 counted writes,应该是利好一些 fused comm kernels,更好写,速度更快嘛。看着有点像 RDMA 的 write with imm。somehow 写完顺带通知对面一下。感觉很多通算融合要重写了。比如 MegaMoE
vera cpu 也不赖啊,首先是第一次从 pcie 5.0 → pcie 6.0 了,内存带宽来到了 1.2 TB/s,引入了一个空间多线程,貌似还是本质 SMT,不过在双线程的时候,Vera 真切了物理资源的静态对半切分,从而实现线程之间更好的隔离性。当然也可能只是一代 SMT 图省事(from Chips and Cheese)。
https://chipsandcheese.com/p/nvidias-olympus-core-pushing-server
y1s1 啊,Chips and Cheese 文章质量是真高,不过由于现在推理引擎都是 py 写的,这个其实不是很重要。可能更利于的是 rl sandbox。其实服务也开始 sandbox 化是吧,各种 bots。
总之相比 GB300 的 Grade,Vera CPU 确实是个大结果。
然后是第二代 c2c,cpu ↔ gpu 之间是 1.8 TB/s,可以将 HMB4 和 LPDDR5x 看作一个池子,更好的 kv cache offloading 和多模型切换吧。
不过感觉没啥用,因为没那么多模型切,kv cache 感觉也不缺这点?其实感觉 c2c 确实挺尴尬的,因为站在开源的角度,我是可以基于 c2c 做一些优化,但是做完就只有 only nv72 用了。nv72用户很少。
然后是这个 CX9,CX9 对 GPU 的带宽来到了 1.6 Tb/s,不赖,cpu 估计就还是 pcie 6.0 左右,1Tb/s 左右?
CX9 改善这个 incast 的行为,可以在端点编程拥塞控制,数据包调度什么的。又有得 RDMA 的故事讲了,看看谁手快吧,或者谁和 NV 感情好,先拿到 CX9 是吧哈哈。
然后看看我们寄予厚望的 lpx, https://developer.nvidia.com/blog/inside-nvidia-groq-3-lpx-the-low-latency-inference-accelerator-for-the-nvidia-vera-rubin-platform/
一个 tray 有 16 个 lp30 chips, 8GB 的 sram,sram 是 2.4 PB/s 的带宽,这个很爆,然后 dram via fabric 是 512GB。其实我也没摸过 LPX 是吧,我更有意思的是它的接口。
NV 自己点名了 AFD 分离。
对于能放进去的小 dense,感觉 LPX 没啥问题是吧。
对于大 MoE,做 AFD 分离,把 Moe 都放到 LPX 上,比如 k3 吧,1.4TB 的专家权重,这怎么放呢。可能也可以,但 LPX 不是 all to all style 的了。取决于 AFD 架构,通信,调度这边的设计。一个很简单的玩法就是,算 layer i 拿 layer i + 1 的嘛,等你算到 layer i + 1 就自然在了。
另一方面是,lpx 的 sram,需要编译器确定性的静态周期编排,moe 天然动态,这里也需要一点 trade off。
总之 LPX 看起来没有想象中那么有诱惑力吧。虽然硬件确实很猛,但是感觉没想好,怎么接入大 MoE 的推理。
最后是这个 Rubin CPX,somehow 因为 prefill 不吃显存带宽太多,那就用个便宜的对吧,反正是算力密集。然后是个 NVL144 CPX。感觉挺对的。
不过都是一个个大托盘卖的话,我怎么配 p/d 比例呢,这也蛋疼。因为 D 肯定买,vera gpu 是吧,p 的话买这个 cpx,你只卖托盘的话,对于小 maas,可能都买不起哈哈。
所以未来就是,大 GPU cloud 吃下所有了,只要 vera 正常出货。小 Mass,小 gpu cloud,硬件都不一定买得起,买得起也别扭哈哈。NV 哥只卖大集群。
另一方面是就业,当顶级 GPU 的归属缩减到部分公司,那意味着只有部分人能有经验对吧,这个可能对于就业市场来说,更加收缩了,对于头部人才,可能更加稀缺了。“万卡训练的实习前提是,你有万卡训练的实习。”哈哈哈