DeepSeek V4.1 推理笔记:KV Cache、Engram 与 DSpark
主要看推理层面的事情,不看训练。
顺带插入一个广告,在没有提前拿到权重的前提,kern 在几小时内就完成 dp4 ep4上的 deepseek v4.1 flash 支持,完全对齐官方自带推理脚本的精度。 https://huggingface.co/Pegainfer/kern-deepseek-v41-flash-sm103
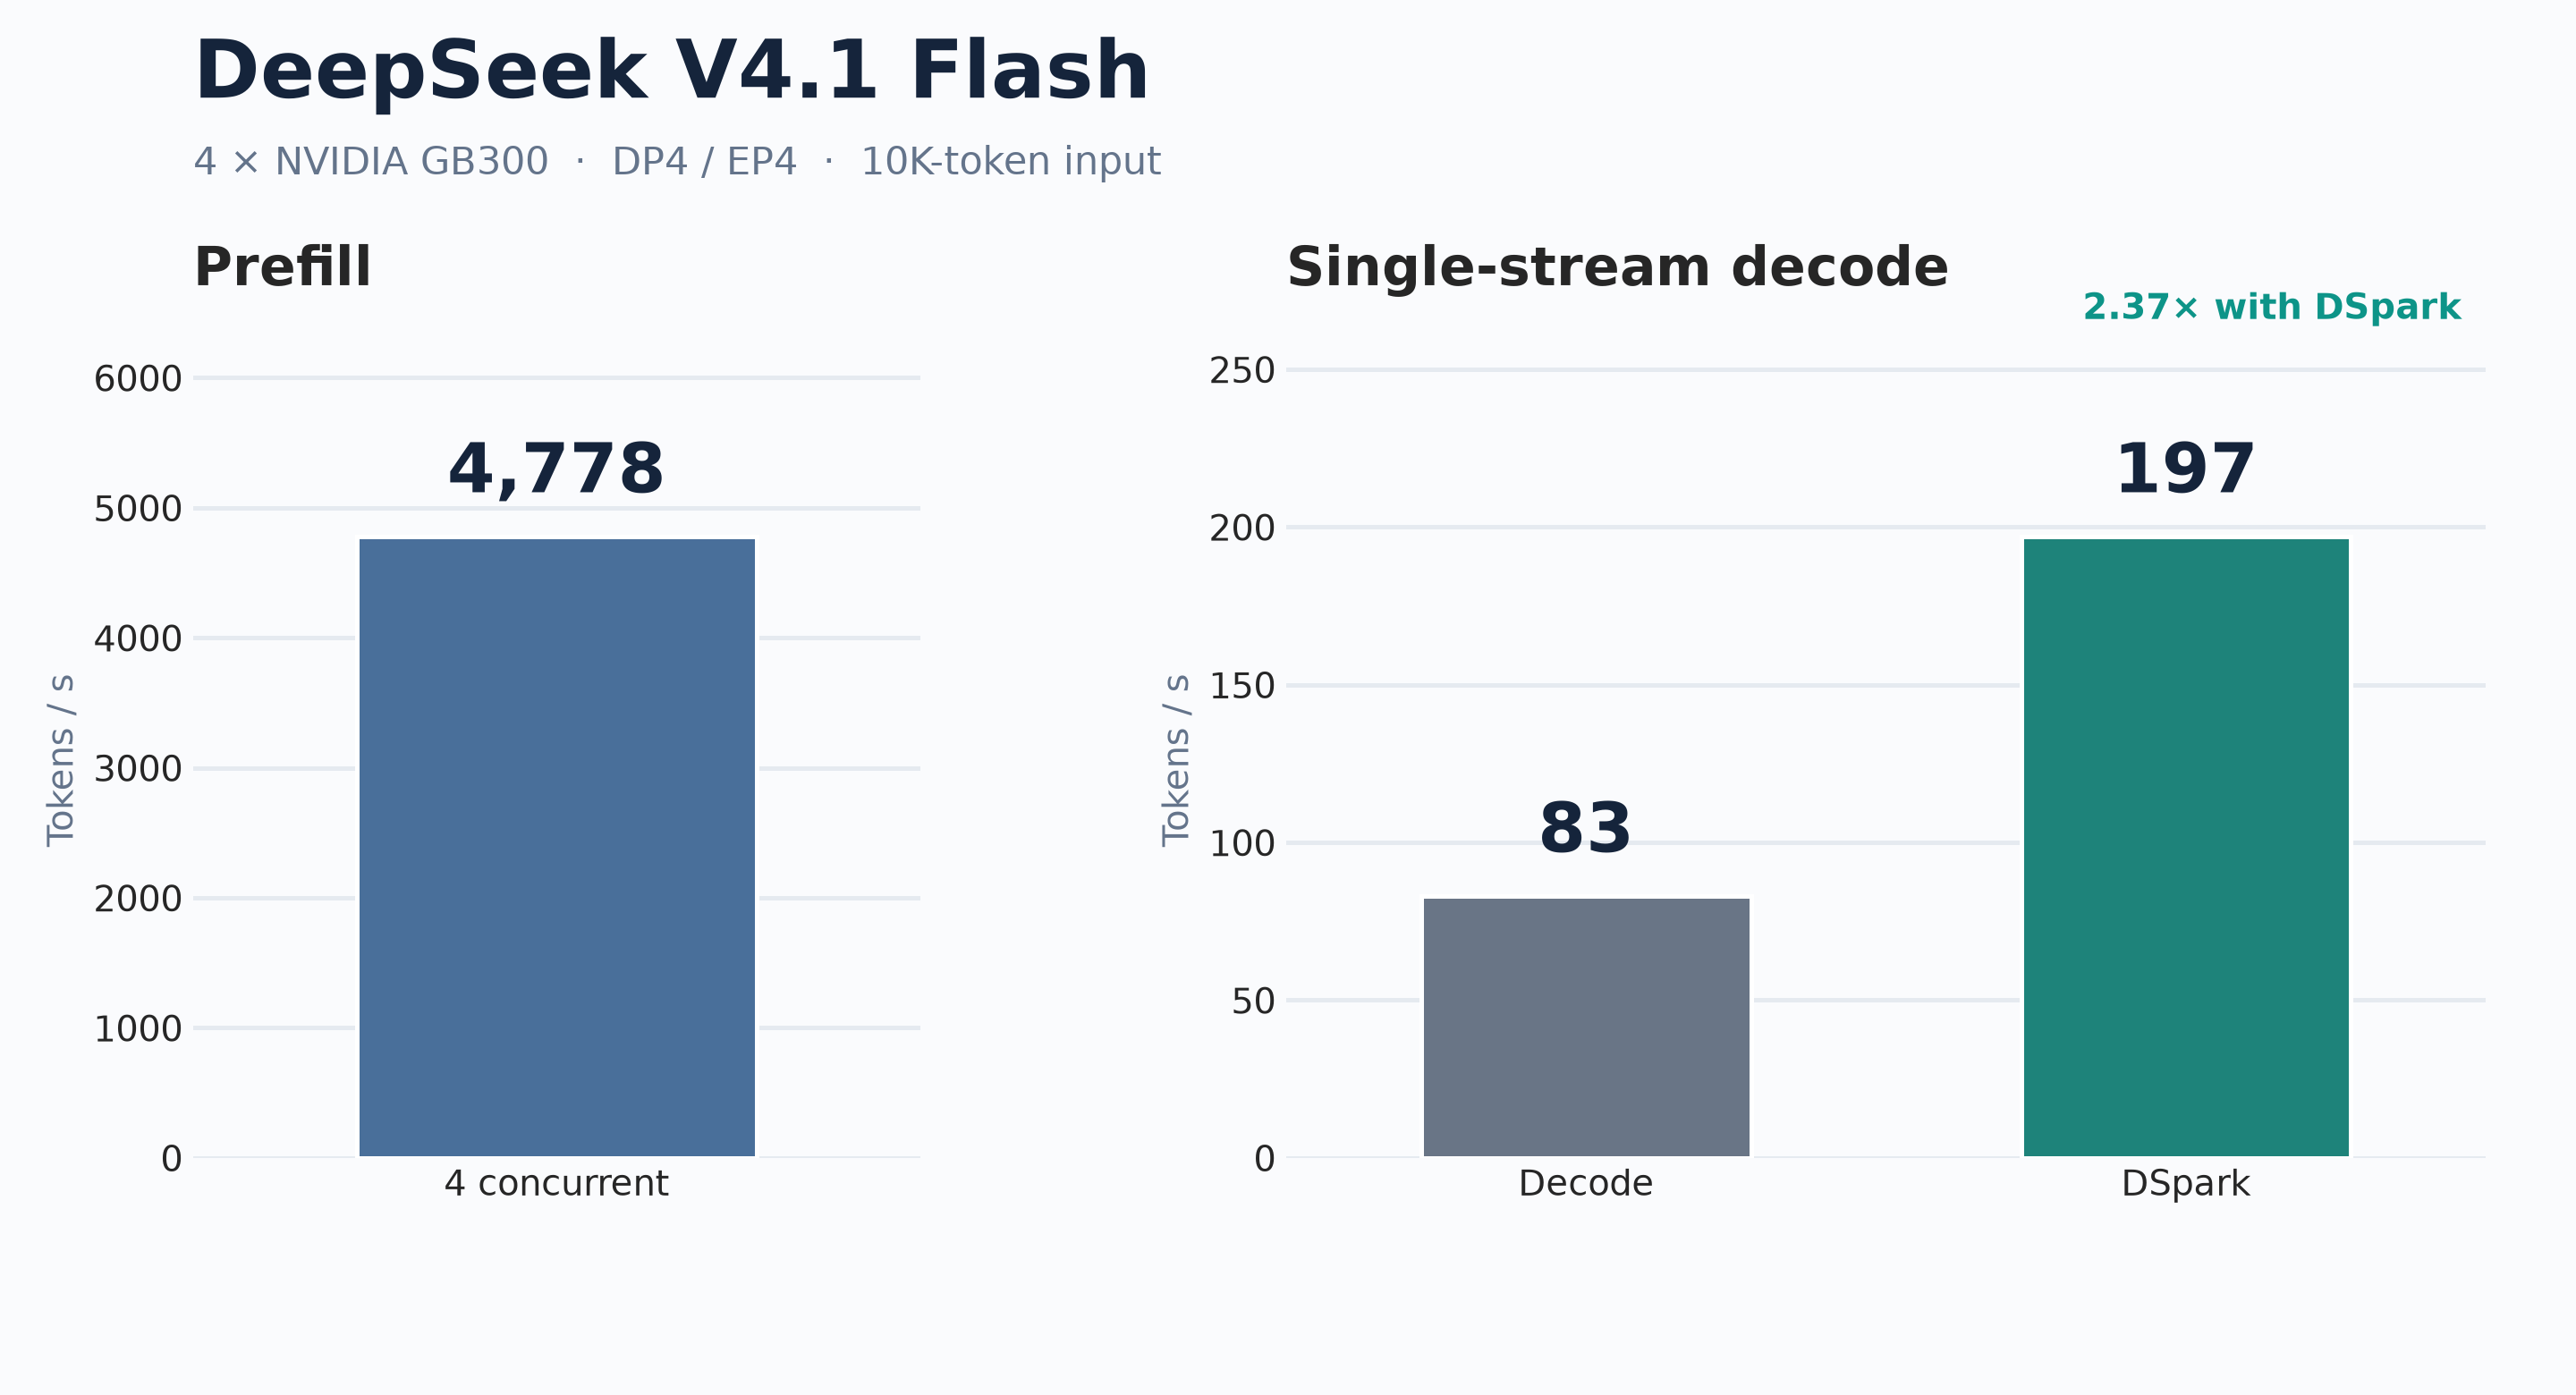
我们把 engram 放到 host memory(一个机器一份),用 UVA 读。
agent workload 带来了高压力的 prefill 负载,尽管 v4 系列已经降低了一些,但 ds 认为还不够。所以 v4.1 继续下降 flops 和 kv cache 大小。
KV Cache部分
v4有两类 kv cache
- 私有的 local SWA KV:每一层都有自己的 local SWA KV,窗口大小是 128 token,fp8 精度。
- 负责长程任务的 global KV,就叫 Main KV 吧,fp4
SWA 就是 naive SWA。Global KV 有点绕。
简单架构图是这样的
                         当前 query
                            │
                ┌───────────┴───────────┐
                │                       │
          Local SWA                 Global CSA2
        最近 128 token               长期历史
                │                       │
          per-layer KV             Indexer 选 Top-512
                │                       │
                └──────────┬────────────┘
                           ↓
                       Attention
Global 还是先压缩 然后 + Top-k,前 20 层两个 token -> entry,后 20 层 1 个 token -> entry。这个听着比较 v4。
后面 layer 维度也开始压缩, 每层依旧有自己的 Q 和 SWA KV,Global KV定义了三种 layer
- full : 生成自己的 Main kv, 生成 indexer k ,自己算 top-k
- reindex : 复用之前的 Main KV + indexer k,自己算 top-k
- reuse: 复用main kv + indexer k + top-k
前 20 层,最前面两个只有 SWA,后面 18 个 layer 是这样的
[Full(m=2), Reuse, Reuse, Reuse, Reuse, Reuse] × 3也就是说 18 层只存 3 份 Main KV / Indexer K,而且每份还是 m=2 压缩的
后 20 层是这样的
Full    + Reuse ×3
Reindex + Reuse ×3
Reindex + Reuse ×3
Reindex + Reuse ×3
Reindex + Reuse ×3
也就是说,后20 层实际只有 layer 21 负责新 Main KV 的,其他层都是复用,21 层的 Main kv 也是从20 层的 hidden state 直接投影得到的。
这么做有一个好处是,cache hit 的时候(忽略前 20 层的 SWA),只用前 20 层需要跑 compute tokens,然后拿到[B, T_delta, 5120] ,后 20 层,因只有 layer 21 有 main kv,所以从前面的 tensor 做一个投影,就有后20 层的 Main kv 了,然后后 20 层的话,跑一下 128 token 的 local SWA 恢复。
大致流程如下
1. 全部 delta token
   → 前 20 层做完整 prefill
   → 得到 H20

2. H20 -> 投影出21 layer Main KV -> Main KV 投影得到 Indexer K

3. 因为 Decoder 还有 per-layer SWA KV
   → 拿 prompt 最后 128 个 token 对应的 H20
   → 跑一遍后 20 层 Decoder
   → 得到后 20 层各自的 SWA KV

4. prefill 结束,开始 decode
Top-k 也还有优化,layer 21,因为要构建Main KV 这些,因为要处理自己的 Top-512,本来就要扫描全量上下文,可以顺带构造一个大的 candidate pool,因为后面有些层还是需要自己的 Top-K 的,按历史 8 个位置一组分 block,用 8 个里最高的分数当做 block 的分数,总共选 2048 个 block,也就是 16k 个位置构成了这个 candidate pool,后20 层的 reindex layer 从这里面选,不去扫完整的1M 上下文了。
前 20 层怎么 handle, 假如一个请求 hit,但只有 main kv 没有 swa kv,理论上就像线性注意力那样,要从 0 开始 prefill(因为要构建完整的 SWA),这个显然比较低效, deepseek 决定只 replay 最后的 128 token,更早的不管了。这个精度是有损的,不过报告说几乎不影响最终能感受到的精度。
这么做的好处是什么,V4 报告里,包括 Kimi 这样混合注意力,有一个头疼的问题,对于 SWA 和线性注意力的缓存,存在一个 trade off,就是存的频率和 cache hit。理论上可以完全对齐 full atttn, 64 个 token 存一次,但是大部分时候,这样存是浪费的,同时会带来巨量的存储需求。对于 Kimi,把这个存的间隔隔离足够大就好。
但我认为,agent workload 要”session aware”,而不是“request aware”,deepseek,kimi 有自身的 harness。完全可以用 tokens -> checkpoint 索引,而不是 chunk chain hash 打散,这样我觉得更加有利于“订阅制”的定价,如果 Deepseek 之后想做的话。
因为如果这样索引后,有两个好处
- 存只在 harness 定义的会恢复的阶段存:比如 prefill 存一个 state, decode完存一个 state. 对于 harness 来说,无论用户继续 session,还是 session 回滚了,都是百分之百 hit 的。对于 k3 这样的模型,存储量下降非常可观。因为比如 1k 个 token 存一次,一个 10k prefil,原本需要存 10 个 state,现在只需要一个。
- 更公平的per user 用户存储配额。如果 tokens 前缀前面再加入一个 (user_id,session_id,tokens) 做索引的话,淘汰,配额,更加公平。 比如我可以这么定价,对于一个 user,我至多保存 20 个 session的最近 10 个 turn。
这么做的坏处,是会损失一些“跨 session”的命中。
我还是预测一下:Deepseek 可能会推出订阅绑定自身的 harness,这样 co design 完,系统优化很舒服啊。
Deepseek 也不是完全不存
- Global KV: 放到 SSD 啥的,至少TTL 72h(感觉完全没必要,1h 的 TTL 感觉就占据 99% 的 hit ratio 了?),不过可能人家就是 SSD 多呢。
- 前 20 层SWA KV: 放到一个全局的分布式内存池(不知道为什么大家这么执着 于全局内存池,可能和 ngram 有关我等会看看,没有 ngram 我感觉完全没必要),用 10% 的 容量,大概分钟级别, DS 自己也说,这个 ttl 足够绝大部分对话里。
- 后 20 层 SWA KV:不做 prefix cache,就是算
Engram
按照可解释的话说是“外挂一个超大的知识参数”,但 这都是“可解释”的事情,具体作用,除非模型会说话,它告诉我们。engram 权重约 200GB,不能被 ep 切分,所以必然 要放到 host memory 里。对于 vllm, sglang 这样的一个卡一个进程,有可能需要卡数 * 200GB,比如 GB300,一个 tray 4 卡 1TB ,dp4 ep4,就需要 800GB 了 ,这样就放不了 kv cache 了。看 sgl 博客好像也在探讨这个问题。
根据我的实测,UVA 在,GB300 上这条路径是 GPU → C2C → Grace 内存控制器,寻址模式是 ATS:GPU 自己的 TLB 不命中时,要向 CPU 的 SMMU 请求翻译,SMMU 再走 CPU 页表。所以 UVA 随机读的成本由两件事决定:一次 C2C 往返(约 2 µs,比 HBM 随机行读多 2 µs),以及翻译是否命中。翻译缓存覆盖范围有限,页越小覆盖越小;Engram 这种 189 GiB 上均匀随机的查表,是最坏的访问模式。
所以 UVA 必须上大页,上 512MB 的大页后, 189 GiB 只有 378 个页表项,全部常驻翻译缓存,瓶颈回到 C2C 本身。
跨 numa 在 bs 较大时,影响可以接受,所以不需要每个 numa 放一份。但是单独某个卡拉会有带宽下降的问题。
具体延迟测试如下
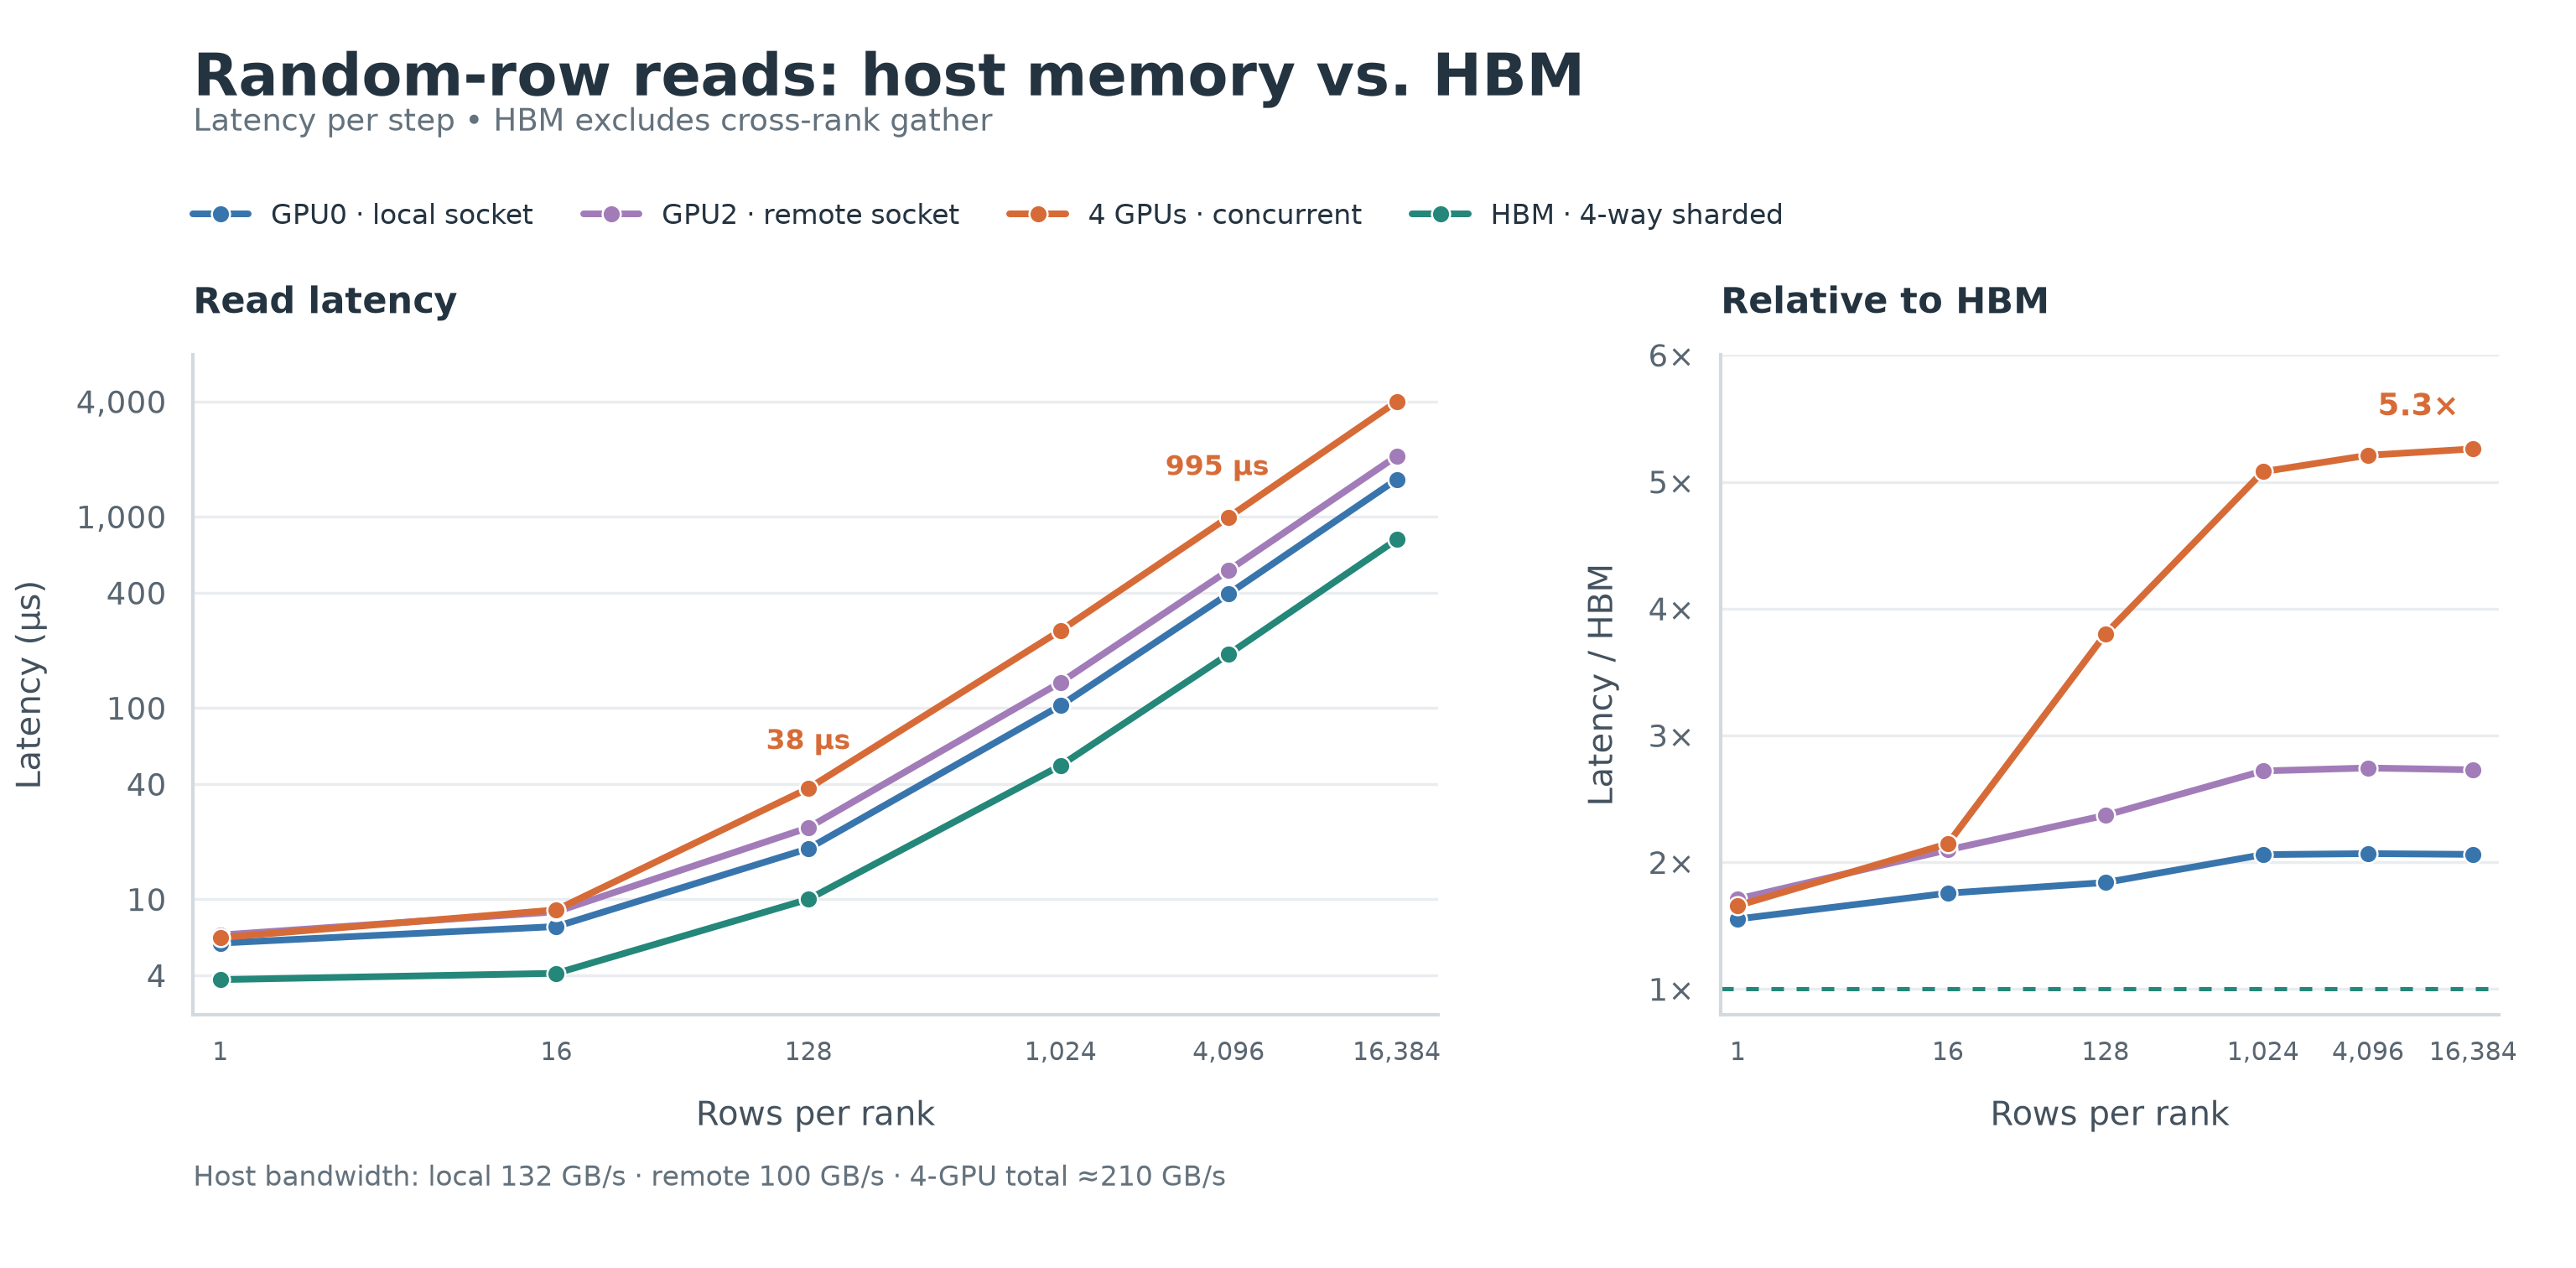
总的来说在 layer 1 layer 14 处,有{2,3,4} 三种 n-gram, 每个 n-gram 有 8 个 hash heads,所以一个 token 逻辑上会查 3 * 8 = 24 个 embedding rows,随机读 24 次,一个 token 合计需要读大约 6KB 的数据量。这个 index 可以直接拿 token 算出来,根据DS 说的,它用的 RDMA 从主机内存中 prefetch,因为它放到 layer1,所以可以和 layer 0 voerlap。RL 的时候,Deepseek 说放在 GPU 里(可能是因为要更新?)。没有 RL 训练过,母鸡了。
然后 DS 进行了一些小架构改动,让更多 kernel fuse 起来。融合了各种东西,最后效果来说 ,对于绝大部分 layer,prefill 只用 15 个 kernel,decode 只用 11 个 kernel。
部署层面 EPD 架构。视觉处理还蛮有意思的,之后探索一下。
DSpark
DSpark,3 layer, 128 的 SWA,投 5,置信度头。这些DSpark 自己论文探索的比较多了。
训练上,是预训练好后,DSpark 才训,然后后训练的时候,再让 DSpark 和 Target Model 一起训,又能加速生成,也能顺带继续训 DSpark。